# 从Demo到生产:大模型工程化落地的鸿沟与填平路径
> **研判日期**:2026年8月
> **核心命题**:为什么90%的大模型Demo永远走不出会议室?
> **导读**:会议室里惊艳全场,上线三天鸡飞狗跳——不是AI不行,是"工程化"没做。这篇把Demo到生产之间的五层塌陷逐层拆开,给一条能走通的路。
---
## 一、核心摘要
2026年,大模型技术展示(Demo)与生产环境部署之间的鸿沟,已成为AI产业最大的"死亡谷"。演示时流畅智能的AI应用,一旦接入真实业务系统、面对真实数据、承受真实流量,往往暴露出可靠性不足、性能衰减、维护困难等致命问题。
数字同样残酷:IDC 预测 55% 的中大型企业启动AI项目,但仅不到20%能实现预期的业务价值回报——**大部分项目死在"从演示到生产"的峡谷里。**
本报告把这道鸿沟拆成五层塌陷(数据、性能、可靠性、集成、运维),解释它为什么这么深,然后给出一条被反复验证的路径:原型验证 → 试点运行 → 生产上线 → 规模运营,四步渐进,每步都有明确的准入和退出标准。
> **案例·"套壳应用"的集体退潮(2023年)**:ChatGPT 爆红后,大量"套壳"应用三个月内冒出来,又三个月内死掉——它们本质上都是"Demo级产品":调用同一批模型API,没有数据壁垒、没有工程护城河、模型一升级或政策一收紧就失去生存空间。明星写作应用 Jasper 在 ChatGPT 直接冲击下估值缩水、被迫裁员转型,就是那轮退潮的标志性事件。**Demo证明了可能性,但活下去靠的是工程。**
---
## 二、工程化鸿沟的"五层塌陷"
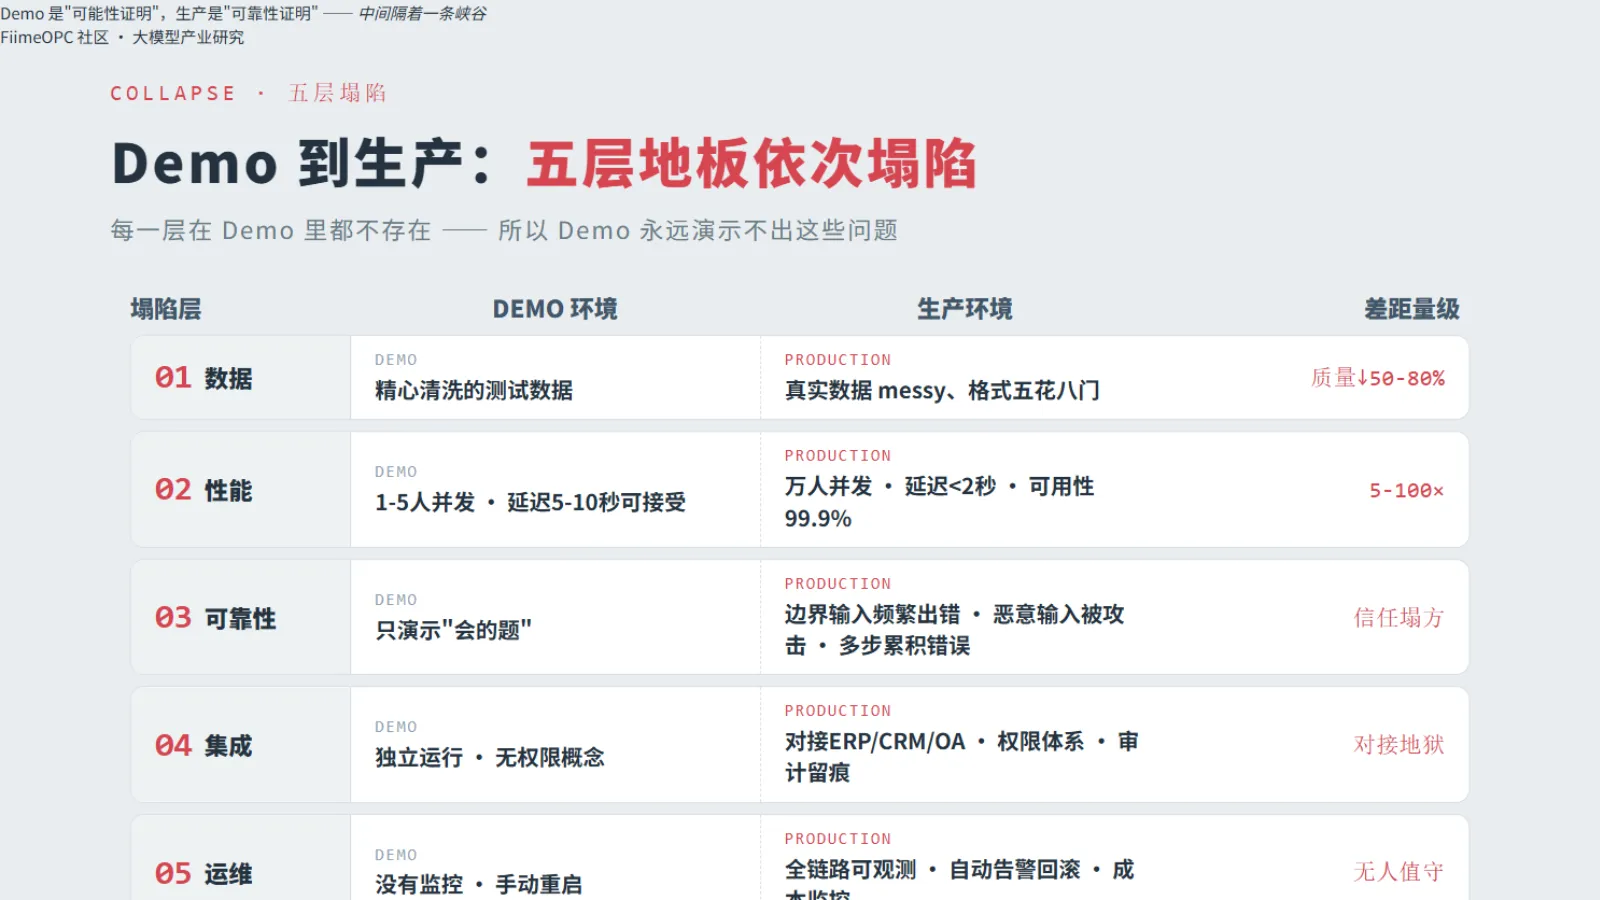
Demo到生产之间,有五层地板会依次塌陷。
### 2.1 第一层:数据塌陷
| Demo环境 | 生产环境 | 差距 |
|------|------|------|
| 精心清洗的测试数据 | messy 的真实业务数据 | 数据质量下降50-80% |
| 标准化的输入格式 | 五花八门的用户输入 | 格式兼容性爆炸 |
| 小规模数据集 | 海量数据带来的性能瓶颈 | 响应时间增加10-100倍 |
**典型症状**:"演示时很流畅,一碰真实数据就卡住"——真实用户不会按你预设的格式提问。
### 2.2 第二层:性能塌陷
| 指标 | Demo | 生产 | 要求 |
|------|------|------|------|
| 并发用户数 | 1-5人 | 100-10000人 | 线性扩展 |
| 响应延迟 | 5-10秒可接受 | <2秒(用户忍耐极限) | 5倍提升 |
| 可用性 | 99%可接受 | 99.9%(企业级) | 10倍提升 |
| 错误恢复 | 人工重启 | 自动降级+告警 | 无人值守 |
演示现场一个观众等着不叫事;生产环境上千人同时提问,慢2秒就是工单轰炸。
### 2.3 第三层:可靠性塌陷
| 场景 | Demo表现 | 生产表现 |
|------|------|------|
| 正常输入 | 完美回答 | 基本正常 |
| 边界输入 | 未测试 | 频繁出错 |
| 恶意输入 | 未考虑 | 可能被攻击 |
| 长流程任务 | 单步演示 | 多步累积错误 |
**核心问题**:Agent在开放场景中的决策稳定性不足,"幻觉"和"跑偏"现象影响业务信任度。Demo永远只演示"会的题"。
### 2.4 第四层:集成塌陷
| 层面 | Demo | 生产 |
|------|------|------|
| 系统对接 | 独立运行 | 需对接ERP/CRM/OA等现有系统 |
| 权限管理 | 无 | 需适配企业复杂的权限体系 |
| 数据流转 | 单向 | 需双向同步,保证一致性 |
| 审计合规 | 无 | 需操作日志、审批流、数据留痕 |
**典型症状**:"页面很智能,一对接内部系统就暴露权限和接口短板"——AI再聪明,进不了内网就是玩具。
### 2.5 第五层:运维塌陷
| 维度 | Demo | 生产 |
|------|------|------|
| 监控 | 无 | 需全链路可观测性 |
| 告警 | 无 | 需异常检测+自动告警 |
| 回滚 | 手动 | 需自动化回滚机制 |
| 迭代 | 随意 | 需灰度发布+A/B测试 |
| 成本控制 | 无 | 需实时成本监控 |
五层塌陷的共同点:**Demo里它们都不存在,所以Demo永远演示不出这些问题**——这就是鸿沟最深的原因。
---
## 三、工程化鸿沟的深层原因
### 3.1 "演示文化"的盛行
当整个行业都在为Demo鼓掌,就没有人愿意花一年时间修"下水道"。
### 3.2 工具链的缺失
```
传统软件开发工具链:
需求 → 设计 → 开发 → 测试 → 部署 → 监控 → 运维
(成熟、标准化、工具完善)
大模型应用开发工具链:
Prompt设计 → 模型调用 → ??? → ??? → ???
(大量空白,缺乏标准工具)
```
传统软件有几十年的工程积累,大模型应用的工具链还在"填空"——好在2026年正在快速补齐(见第五节)。
### 3.3 人才结构的错位
| 角色 | 能力侧重 | 缺口 |
|------|------|------|
| 算法工程师 | 模型训练、调优 | 过剩 |
| 产品经理 | 需求分析、用户体验 | 基本满足 |
| AI工程师 | 模型部署、推理优化 | 严重不足 |
| MLOps工程师 | 模型监控、自动化运维 | 极度稀缺 |
| 业务架构师 | AI与业务系统融合 | 极度稀缺 |
又是《人才荒漠》里的结论:**会"训模型"的人过剩,会"养系统"的人稀缺。**
---
## 四、填平路径:渐进式工程化
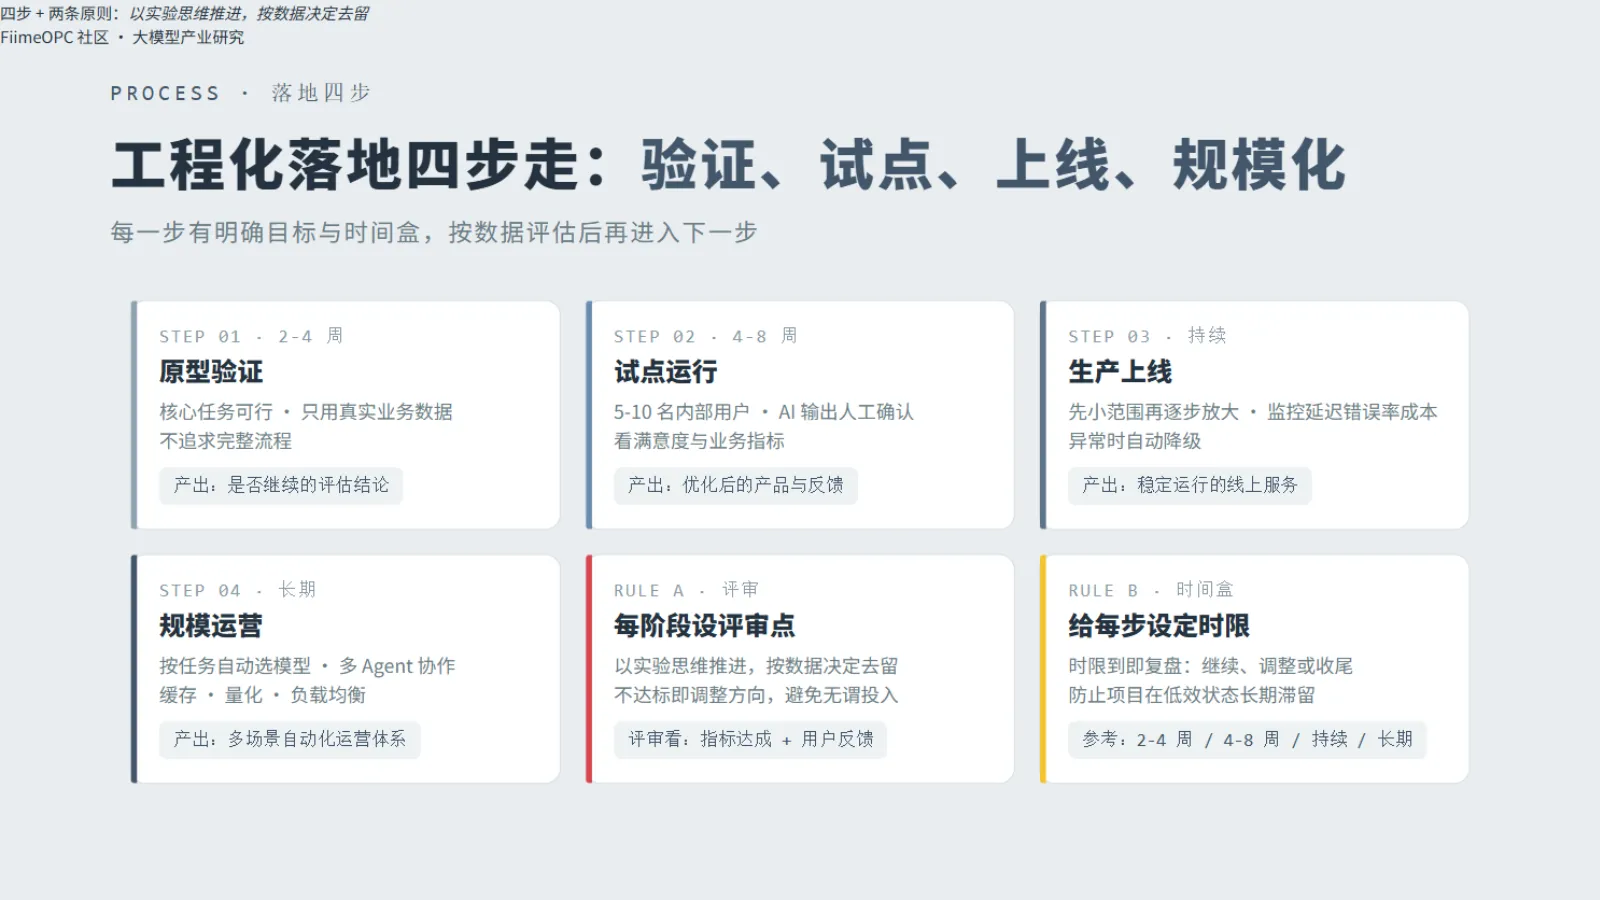
别指望一步跨过峡谷——分四个阶段,每一步都有明确目标和退出标准。
### 4.1 阶段一:原型验证(Proof of Concept)
**目标**:验证AI在特定任务上的可行性
| 要点 | 做法 |
|------|------|
| 范围控制 | 只验证核心任务,不做端到端 |
| 数据要求 | 使用100-1000条真实业务数据 |
| 成功标准 | 准确率/满意度达到可接受阈值 |
| 时间盒 | 2-4周,超时即停止或调整 |
| 产出 | Go/No-Go决策依据 |
### 4.2 阶段二:试点运行(Pilot)
**目标**:在受控的真实环境中验证
| 要点 | 做法 |
|------|------|
| 用户范围 | 5-10名内部用户或小范围客户 |
| 数据范围 | 真实数据,但量级可控 |
| 成功标准 | 用户满意度+业务指标提升 |
| 风险控制 | 人工兜底,AI输出需人工确认 |
| 时间盒 | 4-8周 |
| 产出 | 优化后的产品+用户反馈报告 |
### 4.3 阶段三:生产上线(Production)
**目标**:全量用户、自动化运行
| 要点 | 做法 |
|------|------|
| 灰度发布 | 5% → 20% → 50% → 100% |
| 监控体系 | 响应时间、错误率、幻觉率、成本、用户满意度 |
| 回滚机制 | 自动降级至规则引擎或人工客服 |
| A/B测试 | 持续对比AI方案与人工方案的效果 |
| 迭代节奏 | 每两周一次模型/Prompt迭代 |
### 4.4 阶段四:规模运营(Scale)
**目标**:多场景、多模型、自动化运维
| 要点 | 做法 |
|------|------|
| 模型路由 | 根据任务类型自动选择最优模型 |
| 多Agent编排 | 复杂任务拆解为多个Agent协作 |
| 可观测性 | 全链路追踪、决策路径可视化 |
| 成本优化 | 自动化的缓存、量化、负载均衡 |
| 持续学习 | 基于用户反馈自动优化模型 |
四阶段的精髓是**每个阶段都有"时间盒"和"Go/No-Go"**——不达标就止损,绝不让Demo项目无限期烧钱。
---
## 五、关键工具链
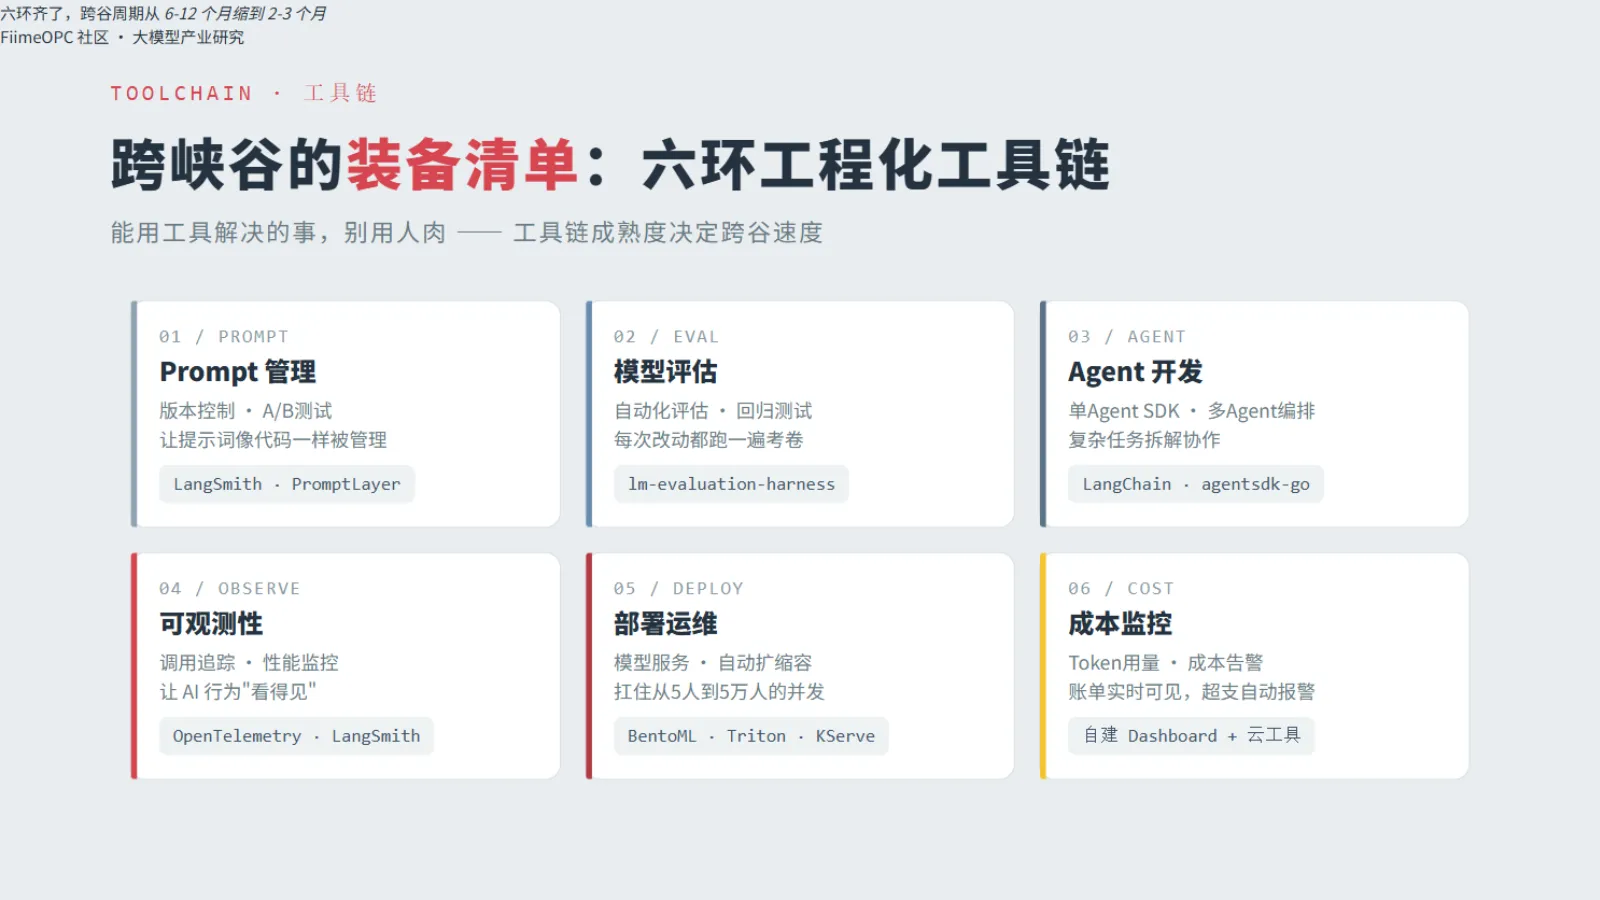
| 环节 | 工具类型 | 代表工具/框架 |
|------|------|------|
| Prompt管理 | Prompt版本控制、A/B测试 | LangSmith、PromptLayer |
| 模型评估 | 自动化评估、回归测试 | ai-eval、lm-evaluation-harness |
| Agent开发 | 单Agent SDK、多Agent编排 | agentsdk-go、myclaude、LangChain |
| 可观测性 | 调用追踪、性能监控 | LangSmith、OpenTelemetry |
| 部署运维 | 模型服务、自动扩缩容 | BentoML、Triton、KServe |
| 成本监控 | Token用量、成本告警 | 自建Dashboard + 云厂商工具 |
工具链的成熟度,直接决定"跨峡谷"的速度——**能用工具解决的事,别用人肉。**
---
## 六、趋势展望
---
> **核心结论**:Demo是"可能性证明",生产是"可靠性证明"。大模型产业的最大瓶颈不是技术不够强,而是工程化能力不够扎实。企业必须建立"渐进式验证"的文化,用数据驱动替代感觉驱动,用工程纪律替代技术浪漫。