有人认为大模型已经显露出通用智能的火花,有人认为它们只是在熟悉分布上表现惊人,仍缺乏真正的新任务适应能力;还有研究者把重点放在世界模型、规划和持续学习上。看似在回答同一个问题,实际常常使用不同的“智能”定义。
本文并不记录一场真实举行的圆桌,也不为任何人编造发言。它把 DeepMind、François Chollet、Yann LeCun、微软研究团队和 Stanford CRFM 的公开论文放到同一组问题下,组成一场“纸上圆桌”。其中有实验证据,也有研究议程,两者不能混为一谈。
## 第一问:大家说的 AGI 是同一件事吗
AGI 通常译为通用人工智能,但“通用”可以指任务覆盖广、能够学习新技能、达到熟练人类水平、在真实环境自主行动,或对经济活动产生广泛影响。这些标准并不等价。
DeepMind 的“Levels of AGI”框架用两个维度讨论系统:能力有多深,以及覆盖任务有多广。它还把表现分成从初现到超人等层级。这个做法的价值不是宣布某个模型已经到哪一级,而是把“通用”和“强大”拆开。一个棋类系统可以远胜所有人,却仍然很窄;一个聊天模型覆盖很多任务,也可能在每项任务上不稳定。
2026 年 DeepMind 又提出认知能力框架,把感知、记忆、推理、学习和元认知等能力分开测量。AGI 更可能是一张不均匀的能力剖面,而不是某天突然亮起的一盏灯。
## 第二问:会做很多题,就等于一般智能吗
微软研究团队在《Sparks of Artificial General Intelligence》中展示了早期 GPT-4 在数学、编程、视觉、医学、法律等任务上的广泛表现,并认为它可以被看作一种早期但不完整的 AGI。这个判断强调能力的广度与复杂度。
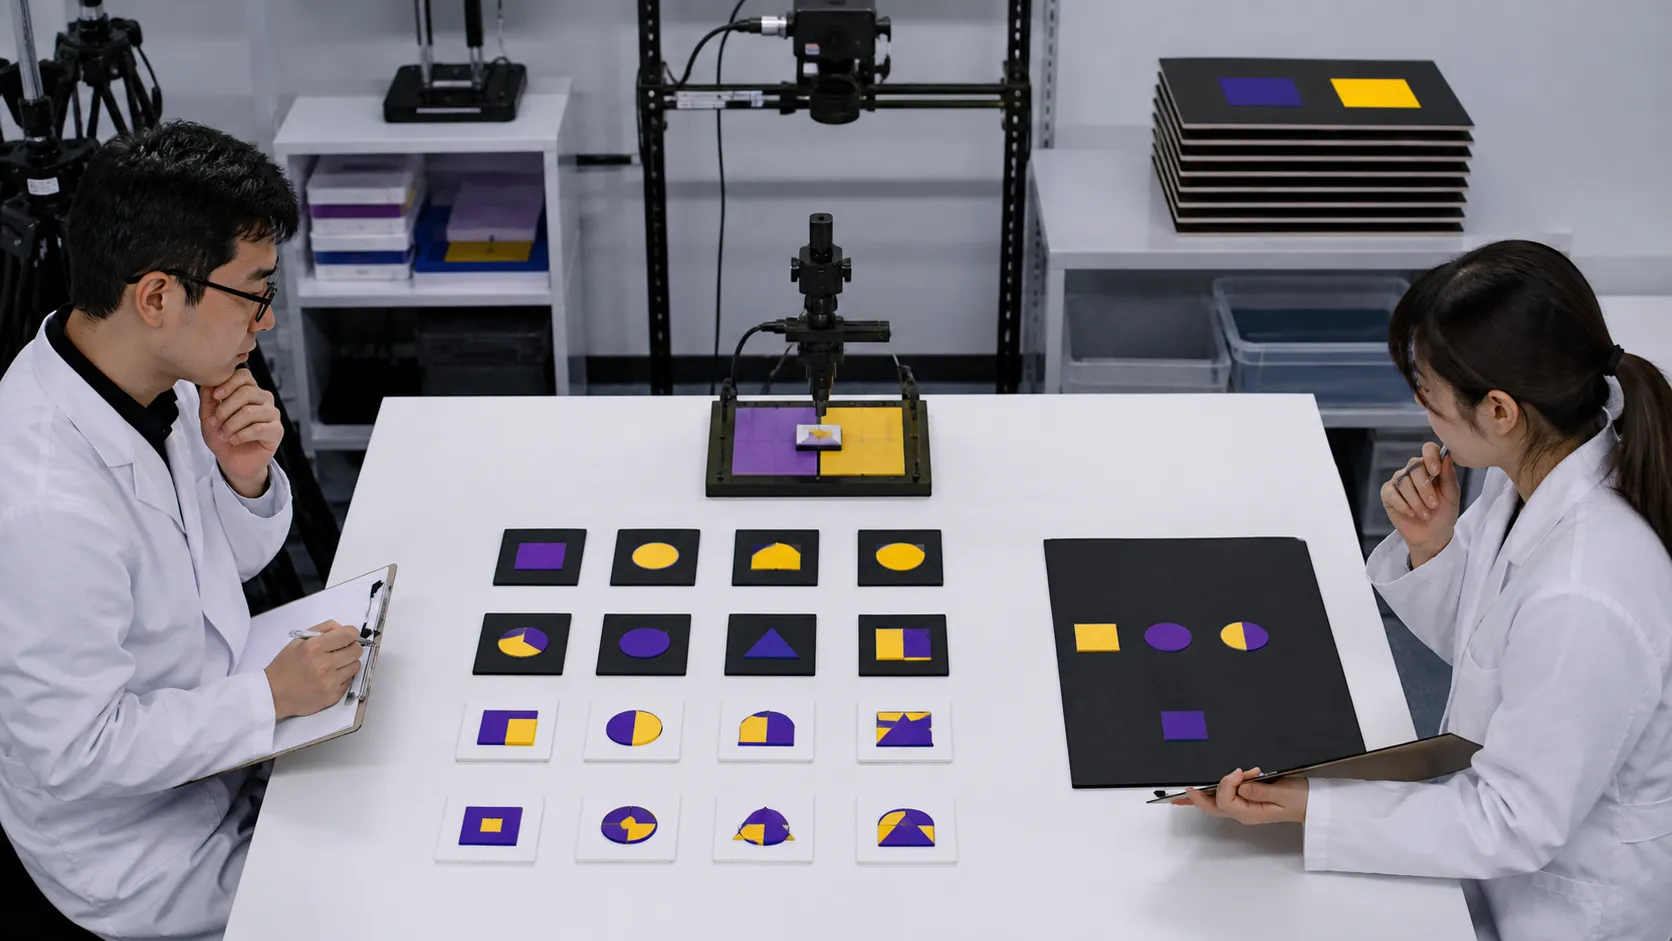
François Chollet 在《On the Measure of Intelligence》中提出另一种重心:智能不只是已有技能的总和,而是利用有限经验高效获得新技能的能力。如果系统在训练中见过大量相似问题,高分可能反映知识与准备程度,不一定反映面对真正新颖问题时的适应效率。
两种观点并非互斥。广泛任务表现是重要事实,但它不能单独回答能力来自记忆、组合、推理还是现场学习。要区分这些机制,测试需要控制训练暴露和题目新颖度。
## 第三问:继续扩大模型,能力会自然出现吗
神经语言模型的缩放定律显示,在一定范围内,训练损失会随模型规模、数据量和计算量呈较规律的变化。这使团队能够预测投入更多资源后基础指标大致如何改善,也解释了为什么“继续扩展”成为一条重要研究路线。
但缩放定律描述的是观测到的经验关系,不是“参数足够多必然产生 AGI”的数学证明。训练损失下降也不自动代表可靠规划、持续学习或物理常识同步提高。某项能力可能快速出现,也可能在架构和数据不变时长期停滞。
因此,支持缩放路线的人需要给出跨任务的新证据;怀疑者也需要明确指出哪类能力无法由当前方法获得。把“可能继续进步”和“必然通向 AGI”混成一句话,会让讨论失去可检验性。
## 第四问:语言能否承载完整的世界模型
大模型从文字、图像、音频和视频中吸收大量结构,能够写计划、解释因果并调用软件工具。但它们在连续物理过程、长期记忆和开放环境中仍可能犯低级错误。一次流畅回答,不能证明系统内部拥有稳定、可用于行动的世界模型。
Yann LeCun 的《A Path Towards Autonomous Machine Intelligence》是一篇研究立场文,主张智能体需要学习世界的抽象表征,具备记忆、预测、推理、规划与内在目标,而不只是依靠外部监督或逐词生成。它提出的是一条候选路线,不是已经完成的系统。
这场分歧可以转化为实验:让系统在规则不完全说明的新环境中探索,观察它能否用少量交互建立预测模型,面对干扰后重新规划,并把学到的原则迁移到外观不同的环境。评价对象从“说得像不像”变成“学得快不快、行动是否稳定”。
## 第五问:现有基准为什么总会失效
当一个基准被广泛使用后,训练数据可能包含题目、答案或近似解法,开发者也会围绕该分数反复调优。分数提高既可能来自能力提升,也可能来自测试泄漏和针对性训练。
ARC 试图用少量示例和抽象图形变换测试新任务适应,减少对海量知识的依赖。它抓住了智能的一部分,但仍不是 AGI 的唯一裁判:图形规则任务不能覆盖语言交流、社会理解、长期规划和真实环境行动。
Stanford HELM 强调跨场景、多指标和公开缺口。评测不只看准确率,也看鲁棒性、效率和其他行为;同时承认任何基准都不完整。较科学的做法不是寻找一张终极试卷,而是维护不断更新的测试组合,并清楚记录它没有测什么。
## 第六问:自主性越高,就越接近 AGI 吗
自主性描述系统能连续规划和行动多久,通用性描述它能覆盖多少类型的任务,两者相关但不同。一个仓库机器人可能自主运行很久,却只会搬运;一个语言模型可能回答范围很广,却需要人逐步确认工具调用。
提高自主性会放大误差。单步正确率很高的系统,经过数十步后也可能因一次错误调用偏离目标。因此长期任务应测中间状态、恢复能力、停止判断和资源使用,而不只看最后是否碰巧完成。
讨论“自主 AGI”时,还要写清工具、记忆、重试与人工介入,以及系统能读取和修改什么、失联后如何停止。完整代理与一次无工具作答的模型,不能使用同一把尺子比较。
## 第七问:专家为何给出截然不同的时间表
AGI 时间预测同时依赖定义、技术路线和对未来资源的判断。若把“在多数知识工作基准上达到熟练水平”作为标准,预测可能较近;若要求像人一样从少量经验学习、在开放物理世界长期可靠行动,预测可能远得多。
读者看到“几年内”或“几十年后”时,应追问三个问题:采用什么定义;哪些能力已经有测量;哪些关键突破仍是假设。没有这三项,年份只是观点的浓缩表达。
## 第八问:分歧会不会妨碍风险研究
不需要先证明系统是 AGI,才能研究它的失败。当前模型已经会产生错误信息、误用工具、暴露数据或被输入诱导。更强系统还可能扩大自动化范围和故障影响。这些风险可以通过具体能力和部署条件测量。
科学工作应把抽象担忧变成测试:系统能否识别不确定性,是否会绕过限制,长任务中是否偏离目标,人工监督在多大规模下仍有效。
同样,也不能因为远期风险受到关注,就忽略当前系统的普通工程问题。错误检索、权限配置、过度自动化和缺少回退,往往在任何“超级智能”出现前就会造成现实损失。
## 怎样读一场真正有价值的 AGI 讨论
第一,要求发言者先定义 AGI,不让同一个词在能力、经济影响和自主性之间滑动。第二,区分观测、解释与预测:模型完成了什么是观测,为什么能完成是解释,将来何时突破是预测。
第三,查看测试是否新颖、是否可能进入训练数据、是否报告失败样本与资源预算。第四,比较完整能力剖面,而不是用一个平均分盖过明显短板。第五,把不同路线当成可竞争的研究计划,询问下一项能够证伪或支持它的实验是什么。
这样的圆桌不一定得出“AGI 已到”或“永远不会到”的统一结论。它更重要的产物,是一组定义清楚、证据可查、未来可以被更新的问题。
## 结语:把口号改写成实验
AGI 之所以争议不断,一部分原因是它同时承载技术概念、未来想象和机构目标。专家分歧并不总意味着有人忽视事实,可能只是他们更看重能力广度、学习效率、世界模型或自主行动中的不同部分。
最可靠的阅读方式,是把宏大判断拆成具体实验:系统能否在未知任务上快速学习,能否跨环境迁移,能否长期规划并知道何时停止。定义越清楚,证据越可复现,AGI 讨论就越接近科学,而不是一场关于词语所有权的争论。
## 参考资料