# 2026年AI大模型焦虑图谱与产业困境研究
> **研判日期**:2026年8月
> **研究对象**:AI大模型产业链参与者(企业决策者、开发者、投资者、政策制定者)
> **数据来源**:行业调研、IDC报告、信通院调研、企业访谈、公开案例
> **导读**:这篇是整个系列的"总目录"——把AI行业里所有的焦虑摆在一张图上,看清哪种最要命、哪种被高估,再决定先治哪一个。
---
## 一、核心摘要
2026年,AI大模型已经从"技术炫技"走进"产业深水区"。但有个尴尬的事实:**技术越来越强,赚到钱的企业却没变多**。行业调研给出的数字是:超过55%的中大型企业启动了AI项目,但真正拿到预期业务回报的不到20%。
这不是某一个环节出了问题,而是**十个环节一起出问题**:选模型头疼、AI说胡话头疼、GPU账单头疼、落地工程头疼、算ROI头疼、合规头疼、招人头疼、法律风险头疼、数据不够头疼、技术迭代太快还是头疼。本报告把这十种焦虑画成一张图谱,并找出它们背后共同的病根。
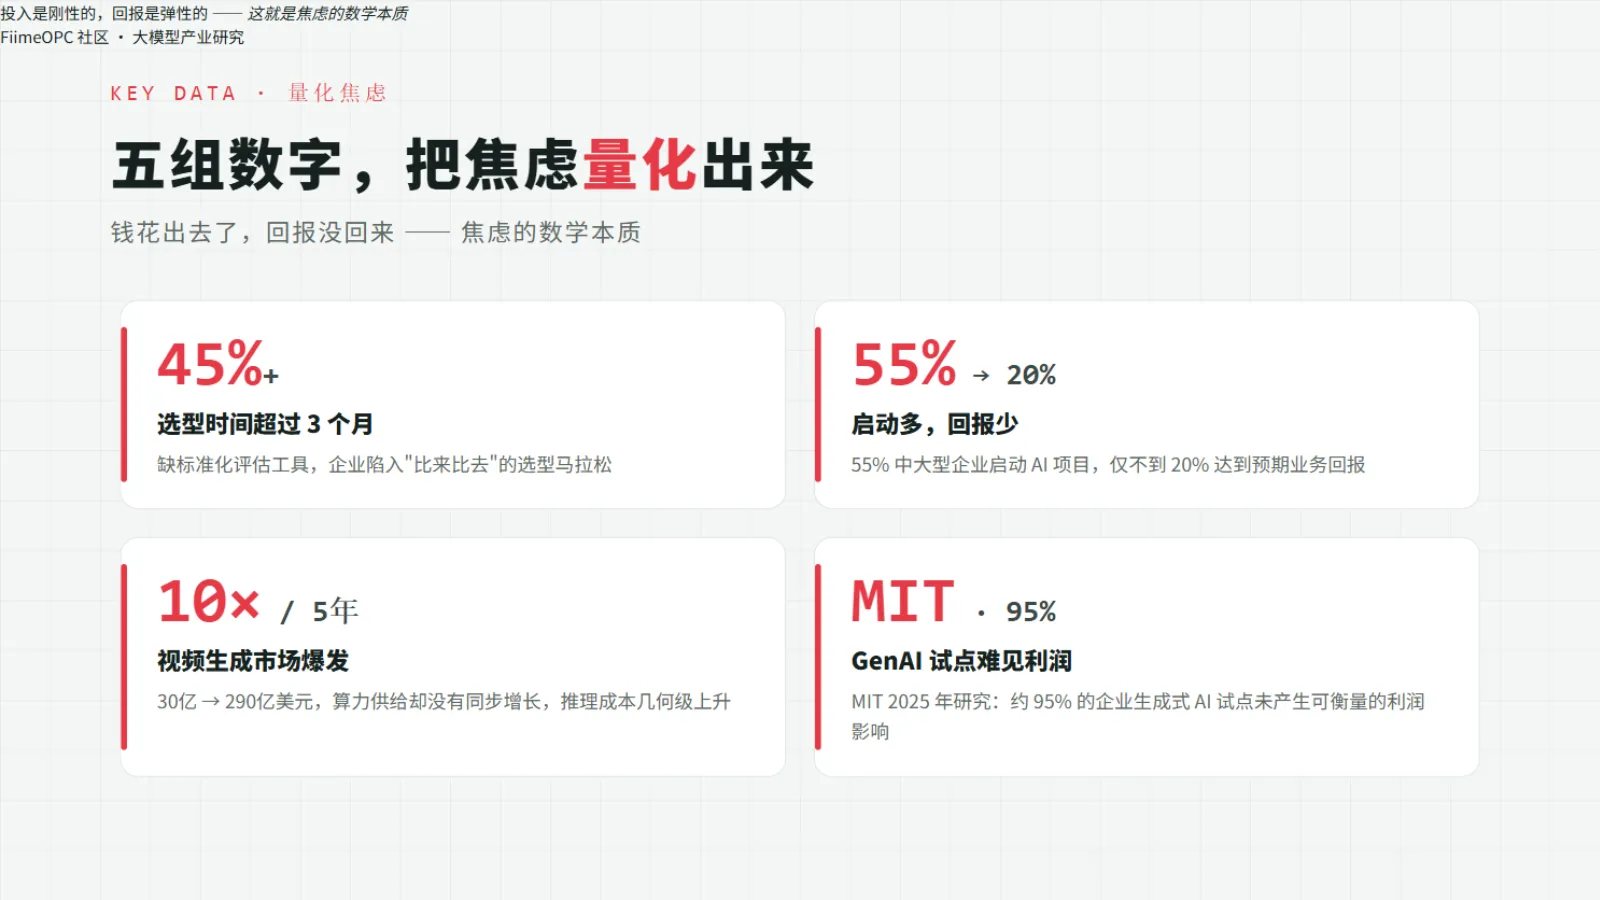
> **案例·焦虑的实证**:2025年8月,MIT 发布了一份广为流传的研究报告(GenAI Divide),结论很扎心:**约95%的企业生成式AI试点,没有产生可衡量的利润影响**。同一年,三星被曝员工把芯片源代码和会议纪要贴进 ChatGPT 导致敏感信息外泄,随即全面禁止办公电脑使用生成式AI。一个说明"投入难有回报",一个说明"用不好还有风险"——焦虑不是空穴来风。
---
## 二、焦虑图谱全景
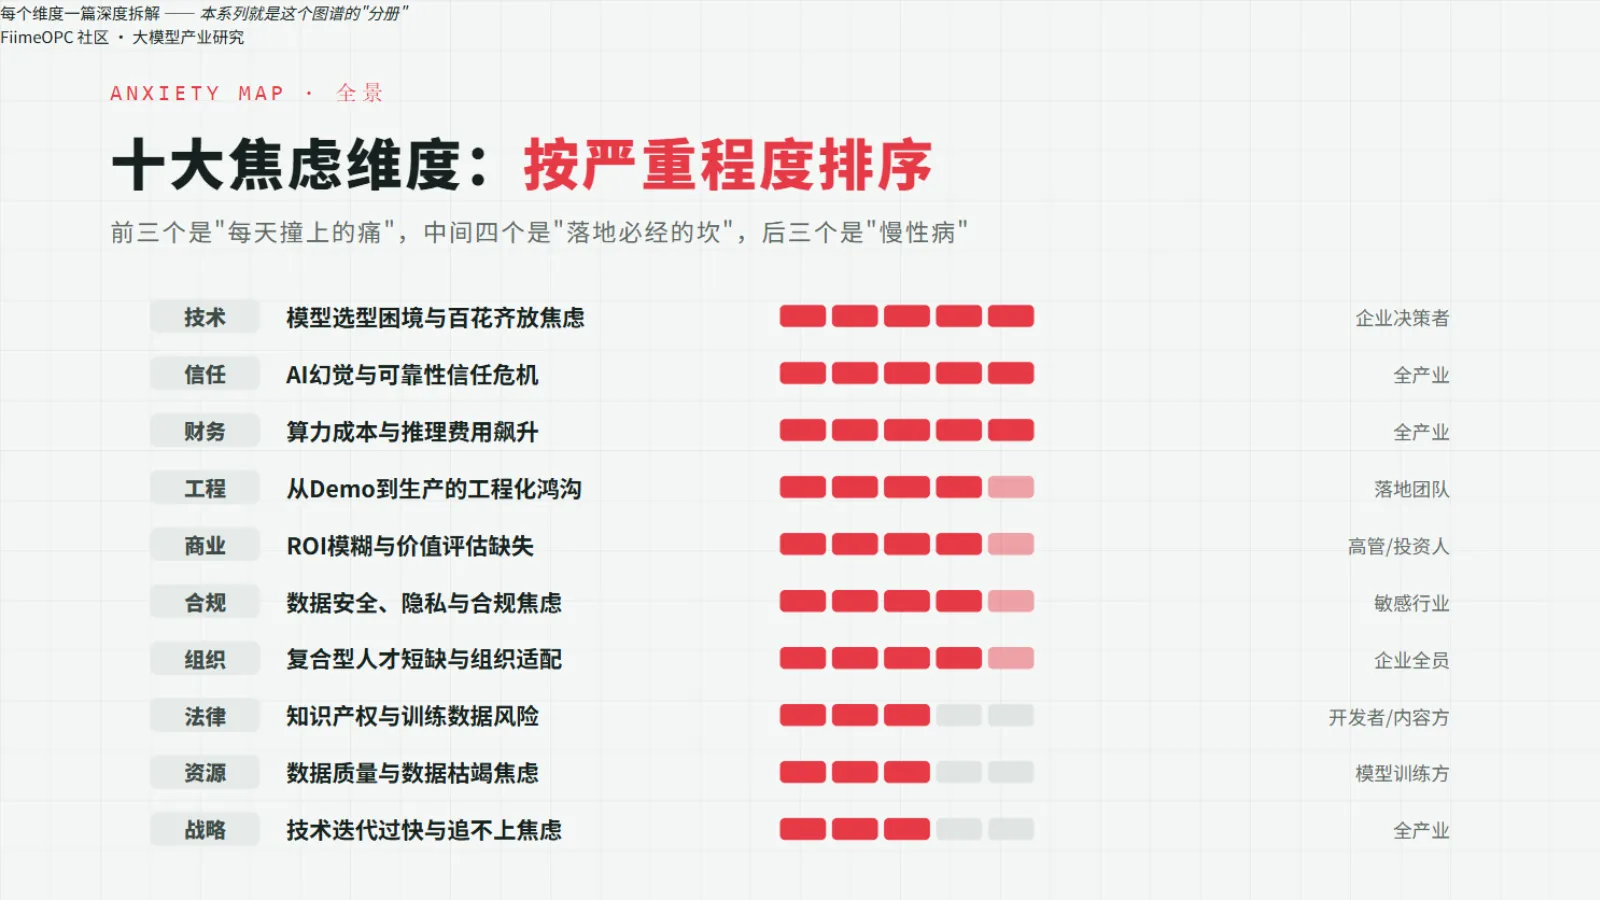
十种焦虑,按严重程度排排坐:
| 维度 | 焦虑点 | 严重程度 | 影响面 |
|:---:|------|:---:|------|
| 技术 | 模型选型困境与百花齐放焦虑 | ⭐⭐⭐⭐⭐ | 企业决策者 |
| 信任 | AI幻觉与可靠性信任危机 | ⭐⭐⭐⭐⭐ | 全产业 |
| 财务 | 算力成本与推理费用飙升焦虑 | ⭐⭐⭐⭐⭐ | 全产业 |
| 工程 | 从Demo到生产的工程化鸿沟 | ⭐⭐⭐⭐☆ | 落地团队 |
| 商业 | ROI模糊与价值评估体系缺失 | ⭐⭐⭐⭐☆ | 高管/投资人 |
| 合规 | 数据安全、隐私与合规焦虑 | ⭐⭐⭐⭐☆ | 敏感行业 |
| 组织 | 复合型人才短缺与组织适配 | ⭐⭐⭐⭐☆ | 企业全员 |
| 法律 | 知识产权与训练数据法律风险 | ⭐⭐⭐☆☆ | 开发者/内容方 |
| 资源 | 数据质量与数据枯竭焦虑 | ⭐⭐⭐☆☆ | 模型训练方 |
| 战略 | 技术迭代过快与追不上焦虑 | ⭐⭐⭐☆☆ | 全产业 |
用人话读这张表:**排前三的(选型、幻觉、成本)是"每天都会撞上的痛"**,中间四个是"落地路上必然遇到的坎",最后三个是"慢性的、但会越来越重的病"。本系列的后续文章,就是按这个顺序一篇一篇拆。
---
## 三、关键数据洞察
五组数字,把焦虑"量化"出来:
1. **选型端**:超过45%的企业在大模型选型阶段花费了3个月以上时间,"缺乏标准化评估工具"是最常被提及的原因。
2. **信任端**:AI幻觉是制约AI从辅助工具升级为核心生产力的最大阻碍,越是性能高级的大模型幻觉问题越严重。
3. **成本端**:全球范围年GPU租赁费用大涨,视频生成行业市场规模5年增长近10倍(30亿→290亿美元),推理成本呈几何级爆发。
4. **落地端**:55%的中大型企业启动AI项目,但仅不到20%能实现预期的业务价值回报。
5. **人才端**:CIO在老板AI焦虑高压下"明知不可为而为之",整个数字化团队面临被裁撤风险。
最扎心的是第4条:**一半以上公司下了场,八成以上没赚到钱。**钱花在哪了?算力、人才、数据——都是沉没成本。
---
## 四、深层结构性矛盾
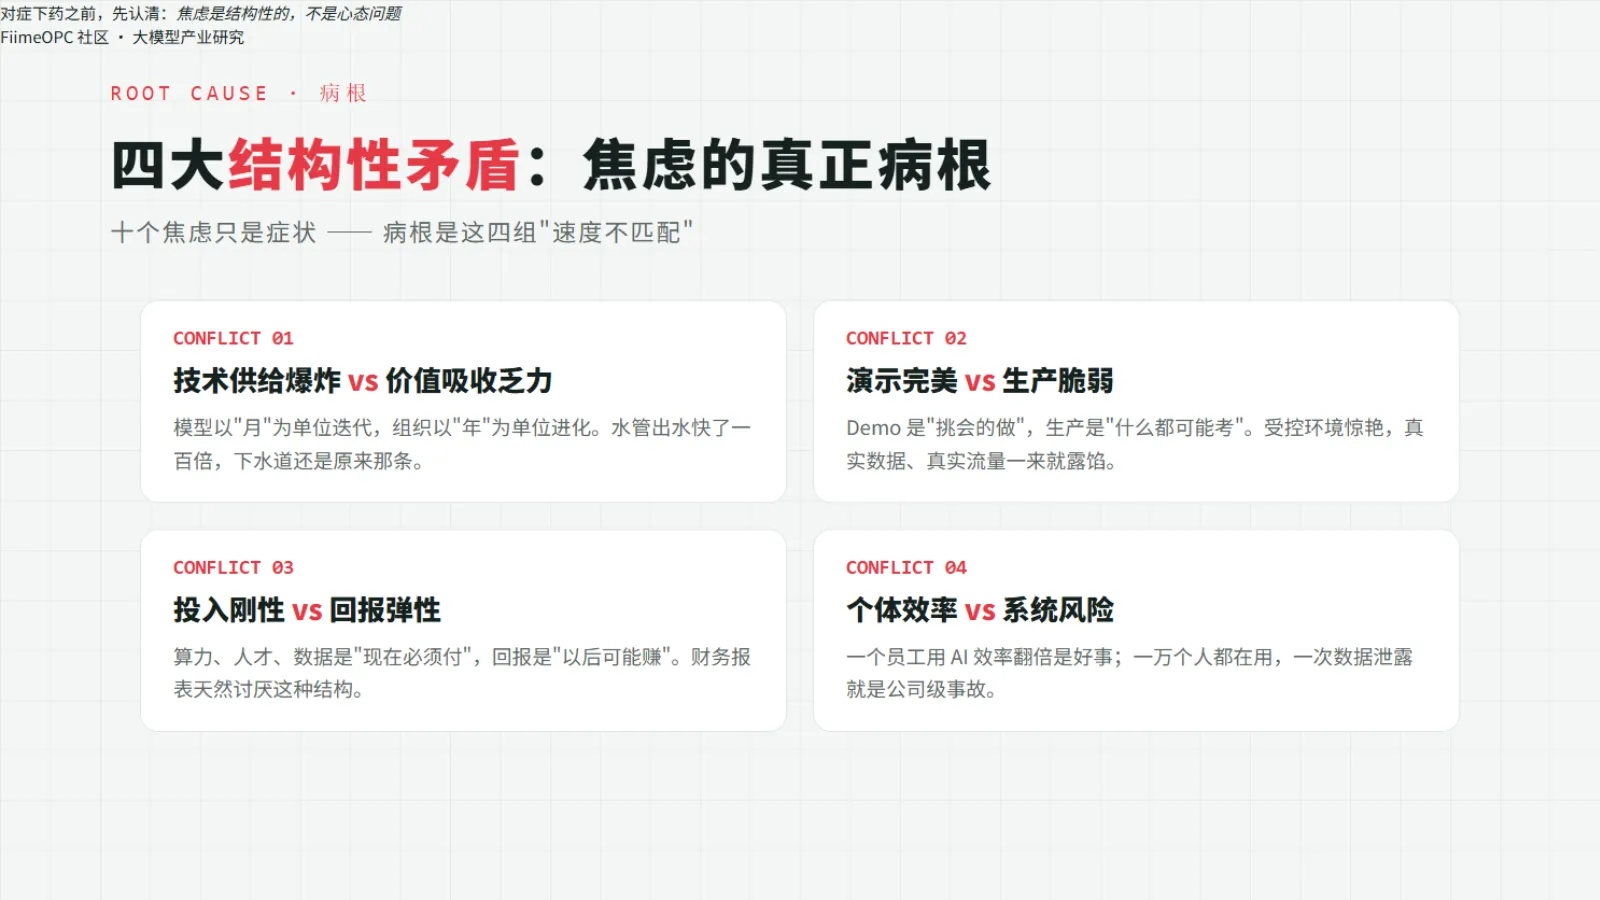
十个焦虑只是症状,背后是四个躲不掉的结构性矛盾。
### 矛盾一:"技术供给爆炸" vs "价值吸收乏力"
大模型技术以月为单位迭代,但企业的组织能力、业务流程、数据基础以年为单位进化。**技术供给曲线与价值吸收曲线之间的鸿沟正在扩大**。
打个比方:水管出水速度提高了一百倍,但你家的下水道还是原来那个下水道。
### 矛盾二:"演示完美" vs "生产脆弱"
大模型的Demo在受控环境下表现惊艳,但一旦接入真实业务系统、面对真实数据、承受真实流量,可靠性急剧下降。**"演示经济"与"生产经济"之间存在巨大的信任落差**。
Demo是"考卷",生产是"高考"——考卷可以挑会的做,高考什么都可能考。
### 矛盾三:"投入刚性" vs "回报弹性"
算力、人才、数据的投入是刚性的、前置的、巨大的,但AI带来的回报是弹性的、滞后的、难以量化的。**这导致大量AI项目在前期试点后因无法论证商业价值而夭折**。
账很好算:投入是"现在必须付",回报是"以后可能赚"——财务报表天然不喜欢这种结构。
### 矛盾四:"个体效率" vs "系统风险"
大模型极大提升了个体工作效率,但也带来了系统性的幻觉风险、数据泄露风险、合规风险。**效率增益与风险敞口同步放大**。
一个员工用AI效率翻倍是好事;一万个员工都在用AI,一次数据泄露就是公司级事故。三星的案例就是矛盾四的现实版。
---
## 五、风险研判
| 风险等级 | 风险类型 | 具体表现 |
|:---:|------|------|
| 🔴 极高 | 幻觉导致决策失误 | 金融对账错误、医疗诊断偏差、法律条款虚构,引发重大损失 |
| 🔴 极高 | 算力成本失控 | 业务增长伴随推理成本指数级上升,盈利模式被击穿 |
| 🔴 极高 | 项目烂尾 | 选型错误+工程化失败+ROI无法论证,数亿投入打水漂 |
| 🟠 高 | 数据泄露/合规处罚 | 使用境外API导致数据出境违规,或训练数据侵权被诉 |
| 🟠 高 | 人才断层 | 复合型人才稀缺导致项目无法推进,或关键人员流失导致项目中止 |
| 🟡 中 | 技术锁定 | 过度依赖单一模型/平台,平台政策变动或技术路线切换导致被动 |
三个🔴级风险的共同点:**都是"钱和信任"级别的损失**。前文三星、MIT的研究、以及后续各篇的真实案例,几乎都能归进这六格。
---
## 六、应对建议
### 对企业决策者
1. **从"All in AI"转向"场景验证"**:选择一个具体、可量化、低风险的业务场景切入,以小步快跑验证价值。
2. **建立AI治理委员会**:统筹技术、法务、业务、财务,避免单一部门决策导致的系统性风险。
3. **预留"止损线"**:为每个AI项目设定明确的阶段性目标和止损条件,避免无限投入。
### 对技术团队
1. **构建评估基线**:建立基于业务数据的模型评估框架,用数据驱动选型而非主观感受。
2. **采用渐进式架构**:从单Agent辅助→Agent链条→多Agent编排,逐步推进工程化。
3. **建立可观测性**:部署Agent追踪、幻觉检测、成本监控工具,让AI行为"看得见"。
### 对政策与生态
1. **推动标准化评估**:行业组织应联合发布大模型评估标准和基准测试集。
2. **完善法律框架**:加快AI生成内容著作权、数据训练合规性的立法进程。
3. **建设公共算力**:通过算力共享平台降低中小企业的算力门槛。
三方建议的共同哲学就一个词:**小步快跑**。别赌大的,先跑通小的。
---
## 七、趋势展望
---
> **结语**:AI大模型的焦虑,本质上是"技术革命速度"与"社会适应速度"之间的张力。技术本身没有错,错的是对技术的过度期待和不当使用。唯有正视焦虑、系统应对、理性推进,才能让大模型真正从"焦虑之源"变为"生产力之基"。