十张AI加速芯片每秒能处理一批训练数据,那么一百张是否就能处理十倍?理论上可以接近,现实中通常做不到。
芯片数量增加后,模型参数、梯度和激活值需要在更多设备之间交换;数据存储要同时喂饱更多训练进程;任意慢节点都会拖住同步步骤;电力与散热也从服务器问题变成机房问题。规模化的本质,不是“拥有更多芯片”,而是让更多芯片在同一任务中持续做有效工作。
## 先理解并行效率
可以用一个简单概念衡量扩容效果:
`并行效率 = 实际加速倍数 ÷ 设备数量倍数`
如果10张芯片扩到100张,训练速度提高了8倍,那么设备数量增加10倍,并行效率约为80%。剩余20%并不一定浪费在同一个地方,可能分别消耗在通信、等待数据、任务调度、检查点保存和负载不均衡上。
规模越大,固定开销越容易暴露。单机内部的高速互连可能很快,跨服务器后却要经过网卡和交换网络。一次微小的配置差异,也会在数百个训练进程同步时被放大。
## 四种并行方式解决不同问题
**数据并行**让每张芯片保存一份模型,分别处理不同批次,再同步梯度。它实现简单,但模型必须能放进单卡内存,而且梯度同步量会随着模型增大。
**参数分片**把参数、梯度和优化器状态拆到多个设备保存。PyTorch FSDP等技术可以降低每张卡的内存压力,不过前向和反向计算时需要按层聚合参数,通信调度变得更重要。
**张量并行**把同一层的矩阵运算分到多张卡。它适合单层已经放不下或计算量很大的模型,但每层都可能产生通信,因此通常需要高速、低延迟的近距离互连。
**流水线并行**把不同层放在不同设备组,微批次像流水线一样依次通过。它降低单设备内存需求,却会产生流水线空泡;若各阶段计算量不均,最慢阶段决定整体速度。
实际大模型往往组合这些方法。选择不是越复杂越好,而要根据模型大小、序列长度、显存容量和网络拓扑寻找通信最少、负载最均匀的组合。
## 网络决定芯片是否在等待
分布式训练中,AllReduce、AllGather、ReduceScatter和AlltoAll等集合通信会反复出现。NCCL等通信库会根据GPU与网络拓扑选择算法,但它无法替代合理的物理连接和进程布局。
同一服务器内的设备、同一交换域中的服务器,以及跨越多级交换机的节点,通信代价可能完全不同。若张量并行组被随意分散到慢链路两端,每一层计算都要等待远程数据。更好的做法是把通信最频繁的并行组放在连接最紧密的设备上,把通信相对较少的数据并行扩展到更远节点。
扩容前应先做集合通信基准,而不是直接运行完整训练。分别测量不同消息大小下的带宽、延迟和跨节点差异,才能知道瓶颈来自链路容量、网卡绑定、交换拥塞还是错误拓扑识别。
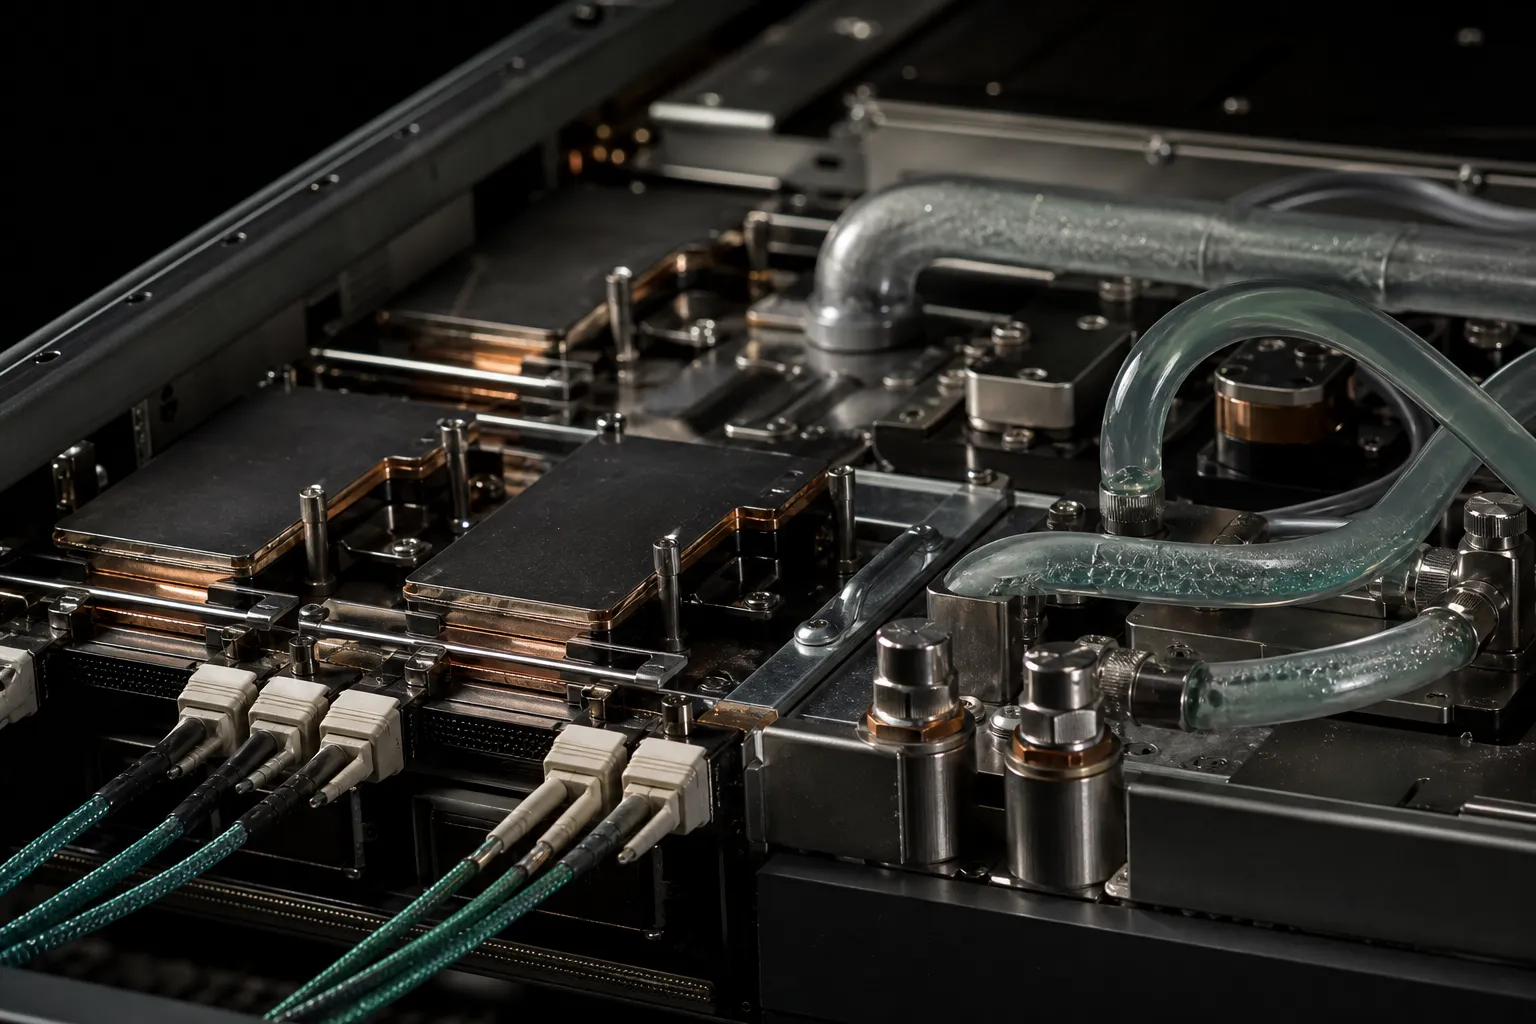
*规模化不是芯片数量的照片,而是计算、通信和散热路径能否同时保持畅通。*
## 数据管线也要增加十倍吞吐吗
当计算设备增加时,每秒需要读取和预处理的样本也随之增长。若所有进程同时访问少量大文件,存储元数据或单个热点对象可能先饱和;若数据解压和分词只依赖CPU,GPU会在每个训练步骤前等待。
常用方法包括把数据分片、在多个工作进程间均匀分配、提前预取、缓存高频数据,并让训练与读取重叠。数据和检查点存储还应尽量靠近计算集群。Google Cloud的TPU扩展指南也强调逐步放大设备规模、保持每核批量合理,并把存储放在相同区域以减少传输瓶颈。
批量大小并不能无限增加。保持每卡批量不变可以提高吞吐,却会让全局批量随着设备数量增长。过大的全局批量可能改变优化过程,影响收敛与最终质量。扩容测试必须同时比较训练速度和达到同等验证指标所需的样本数,而不是只看每秒处理量。
## 一百张芯片意味着更多故障机会
一台机器偶尔出错,在一百张芯片长期共同训练时就更容易遇到。显存纠错、链路重传、驱动异常、网络抖动和存储超时都会中断同步任务。只要某个进程退出,整个训练组通常都需要协调恢复。
因此,检查点间隔要根据保存成本与故障损失共同决定。保存太频繁会占用训练时间和存储带宽,保存太少又会在故障后重算大量步骤。PyTorch Distributed Checkpoint支持多个进程并行保存,并可在不同集群拓扑下重新分片加载,适合设备数量变化后的恢复。
检查点也必须定期做恢复演练。文件成功写入不代表能够完整恢复模型、优化器、随机数状态和数据迭代位置。没有恢复测试的备份,只是一份尚未被验证的希望。
集群还需要识别“慢但未故障”的节点。某张芯片因温度或功率限制降频,某条链路出现重传,任务仍能运行,却让所有其他设备等待。监控应包含每个训练进程的步骤时间、通信时间、温度、功率、时钟、纠错事件和链路错误,而不仅是平均GPU利用率。
## 供电与散热成为系统设计
十张加速芯片可能放在少量服务器内,一百张则可能跨越多个高密度机柜。芯片、CPU、内存、交换机与冷却设备共同形成持续功耗,启动和负载变化还会带来功率波动。
温度超过控制阈值时,硬件会通过降低时钟保护自身。此时监控面板仍可能显示设备“正在使用”,实际吞吐却下降。扩大集群前要验证机柜供电、配电冗余、冷却能力、进出水温、气流与热密度,而不是等训练变慢后才检查温度。
功率上限也不只意味着限制性能。在固定机房功率下,略微降低单卡峰值,有时可以容纳更多设备并提高整体吞吐。正确目标是每瓦有效训练量,而不是每张芯片始终运行在最大功率。
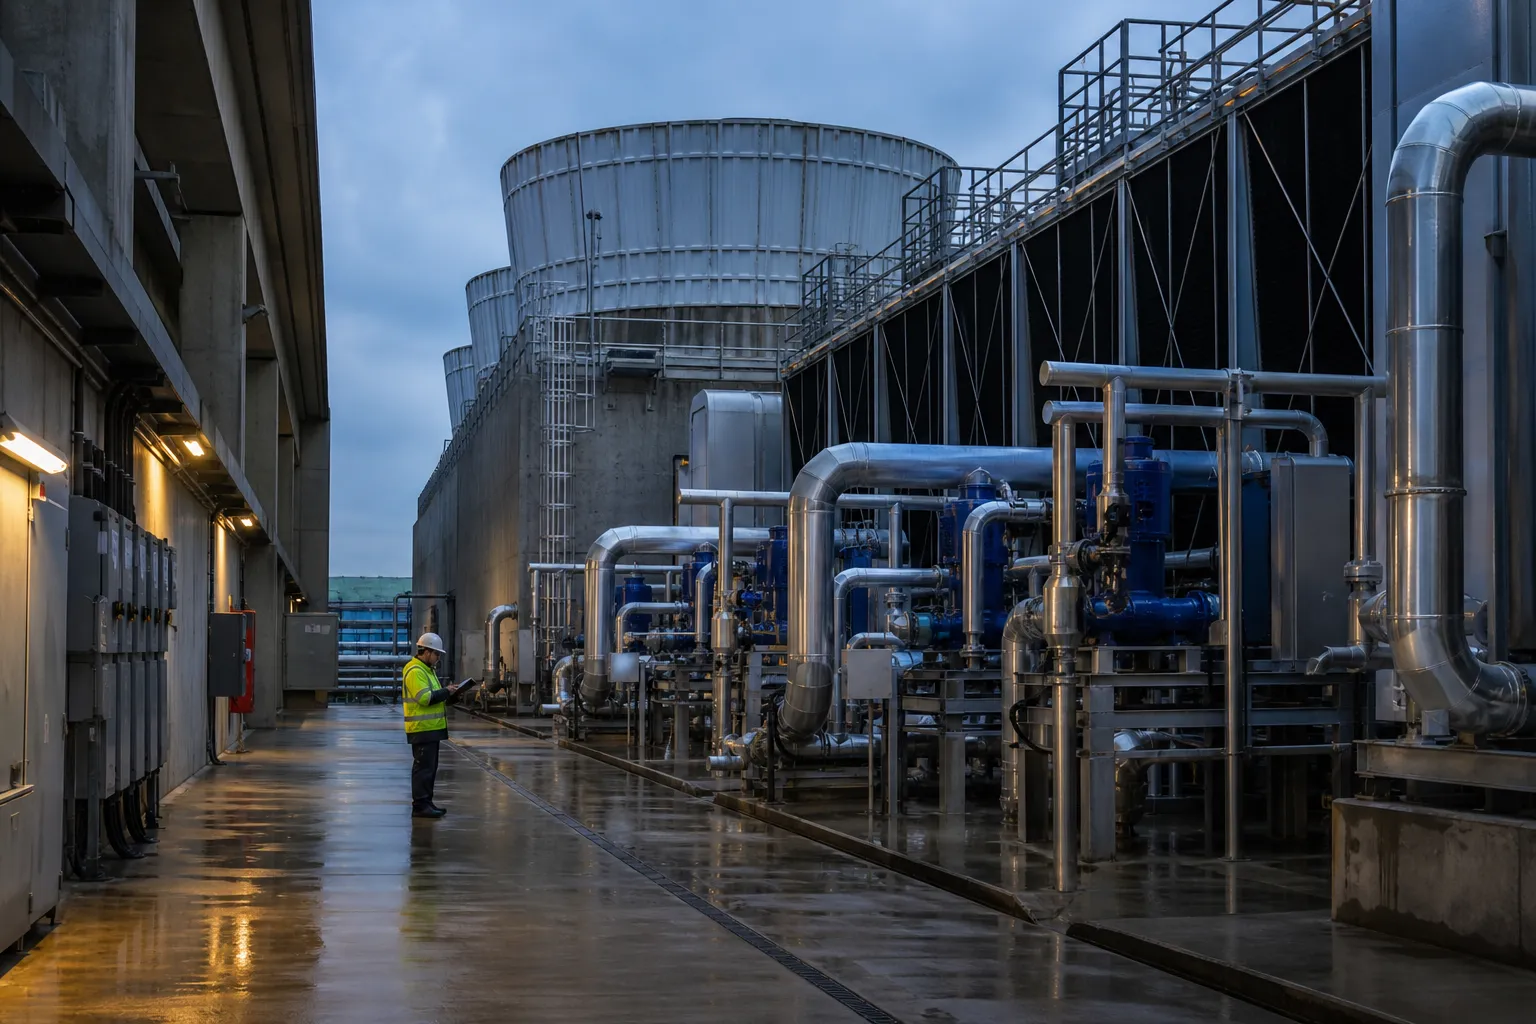
*当规模进入多机柜阶段,供电和冷却不再是背景设施,而是训练性能的一部分。*
## 从10到100的分阶段路线
第一阶段先固定10张芯片的基线。记录单步时间、计算时间、通信时间、数据等待、显存、功率和验证指标,并保证连续运行能够稳定恢复。
第二阶段扩到一个自然拓扑单元,例如单服务器、单机柜或同一交换域内的设备。调整进程绑定与并行分组,确认通信带宽接近基准工具结果。
第三阶段逐步扩大到32、64,再到100张左右。每次只改变少量关键变量,保留相同训练样本数和验证标准,绘制并行效率、每卡吞吐与能耗曲线。
第四阶段进行故障演练:主动结束一个进程、断开测试链路、限制某个节点功率,验证任务能否发现异常、保存状态并在目标时间内恢复。
最后再做长时间稳定性测试。短跑能发现明显通信问题,连续数天运行才会暴露温度漂移、存储累积、偶发链路错误和检查点恢复成本。
## 应该观察哪些指标
最直接的是每秒处理的令牌或样本,但还要配合每芯片吞吐和并行效率。若总吞吐增加、每芯片效率快速下降,继续扩容的边际价值已经变小。
模型浮点利用率可以帮助判断计算单元是否真正忙碌;步骤时间的高分位数可以发现偶发慢节点;任务可用率反映训练时间中有多少用于有效计算;每有效令牌能耗则把性能与设施成本联系起来。
最重要的仍是达到同等模型质量所需的总时间。一个每秒令牌数很高、却因批量与学习率变化需要更多数据才能收敛的方案,并不一定更快。
## 结语
AI芯片从10到100的规模化,是计算、通信、数据、可靠性和设施共同扩展的系统工程。设备数量只是投入,真正产出是经过验证的模型质量和稳定吞吐。
最有效的扩容方式不是一次性把所有硬件接上,而是从可复现基线出发,沿着自然拓扑逐级放大,测量每一步的效率损失,并让检查点、监控和故障恢复与算力同步成长。只有这样,多出来的九十张芯片才不是更昂贵的等待队列。
## 参考资料