模型价格下降、开源权重增加,确实让更多团队可以尝试 AI。但能运行模型,不等于能判断它是否适合自己的任务。缺少测试能力时,选择仍然依赖品牌、演示和单一榜单。
AI 民主化的下一步,是把评测也变成可参与的公共基础设施。学校、小企业和行业团队不仅能看分数,还能理解测试条件、运行自己的任务,并把发现的失败贡献回来。
## 开放评测至少有三层
第一层是任务和数据。每个案例要说明输入、期望输出、来源、适用范围和评分方式。没有这些信息,一个数字无法告诉读者模型究竟会什么。
第二层是评测工具。HELM、LM Evaluation Harness 等开源框架把模型接口、提示模板、指标和运行配置组织起来,使不同模型可以在相同条件下比较。
第三层是结果与轨迹。除了总分,还应保存样本级输出、错误类型、成本、延迟和失败日志。公开失败比公开平均分更能帮助后来者发现边界。
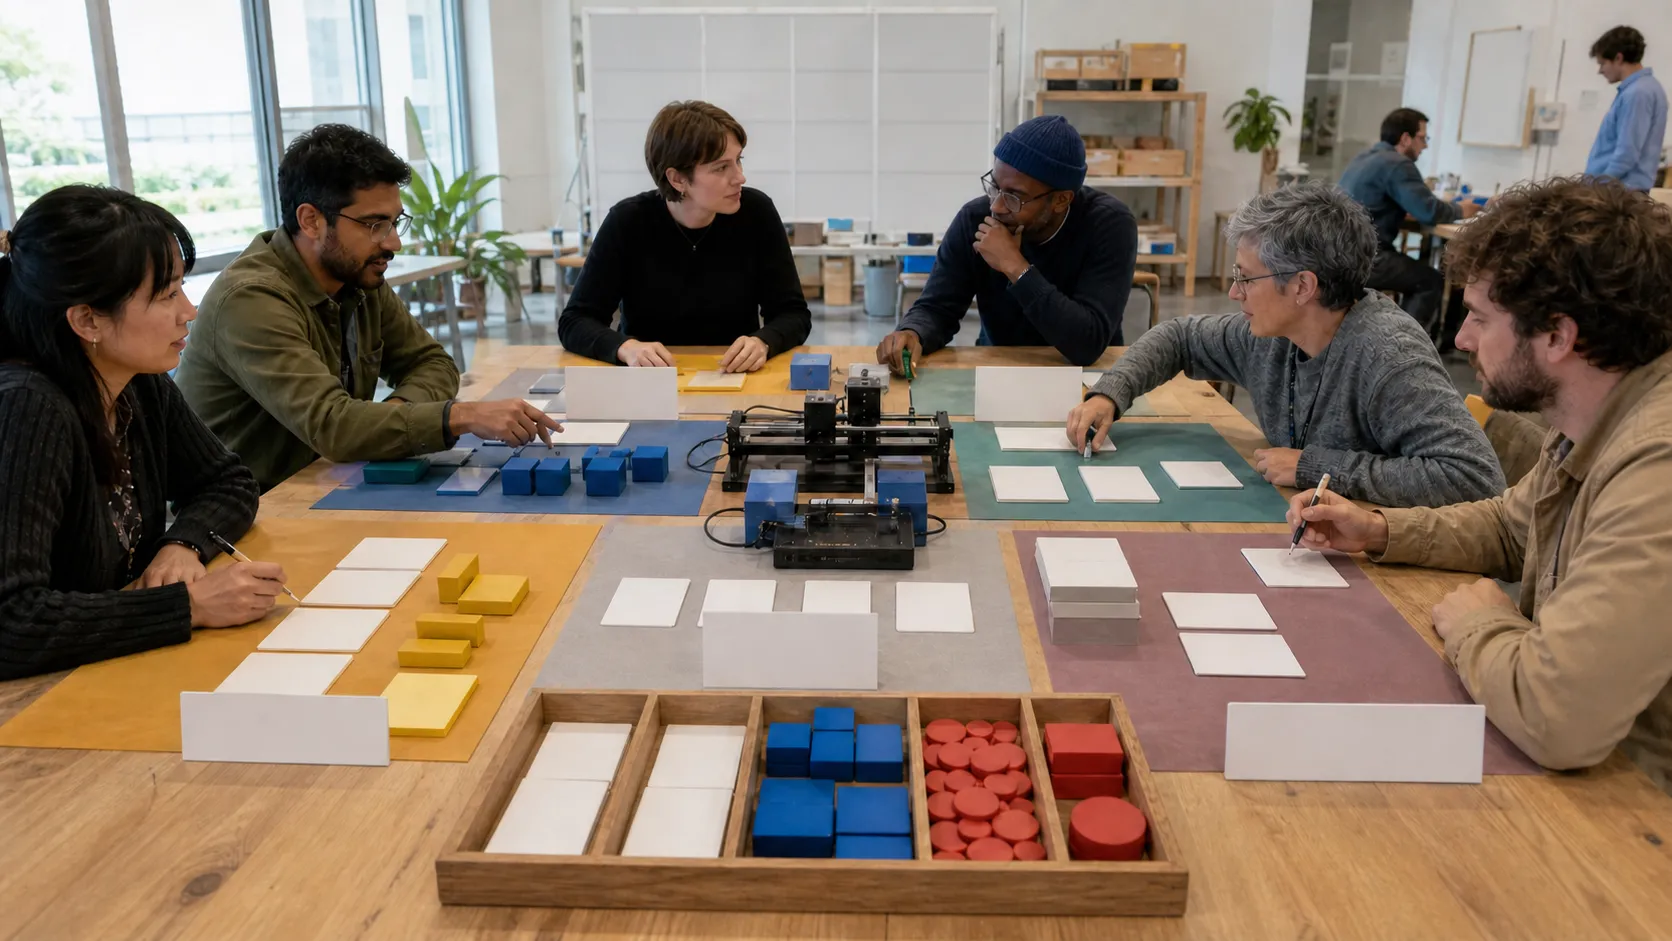
MLCommons 的基准工作还强调规则、可复现和不同组织共同维护。共同规则可以减少随意选择硬件、批量大小或数据预处理造成的不公平比较。
开放合作还需要不同贡献方式。没有算力的参与者可以整理任务定义、翻译案例或复核错误;拥有硬件的机构可以重复运行;领域专家可以判断指标是否真正代表任务。民主化不应把参与等同于训练最大模型。
## 单一榜单为什么不够
模型能力是多维的。一个系统可能在知识问答得分高,却在长文本、低资源语言、工具使用或特定专业任务上表现差。把多个维度压成总排名,会隐藏使用者真正关心的差异。
提示模板也会显著影响结果。有的模型需要特定格式,有的对示例顺序敏感。公平评测不是给所有模型完全相同的一串字符,而是事先规定可接受的适配范围,并公开每个配置。
成本和速度同样重要。面向普通团队的民主化评测,应同时报告硬件、显存、批量、输入输出长度和总费用。只比较最高准确率,可能把无法承担的方案推荐给资源有限的使用者。
## 开放也会带来污染和刷榜
测试集一旦公开,就可能进入训练数据。模型记住答案后,分数会上升,却没有获得相应的泛化能力。研究已经指出,开放基准的透明优势与数据泄漏风险同时存在。
解决办法不是把全部测试永久保密。可以把公开开发集、定期更新集和受控留出集结合;记录模型发布日期与数据来源;用新写案例、扰动和跨域迁移检查记忆。行业团队还应保留自己的真实任务集。
评分器也要被评测。用另一个语言模型判断答案时,需要抽样人工复核,测量评分一致性和偏差。否则排行榜可能只是在比较谁更符合裁判模型的表达偏好。
版本管理决定结果能否长期解释。任务、数据、提示或评分器任何一项变化,都应产生新版本;旧结果保留,但不与新版本直接排序。这样社区能看到能力变化,也能知道变化是否只是测试条件改变。
## 开放合作如何形成闭环
参与者可以先提交失败案例,而不是只提交新榜单。维护者检查案例是否清楚、是否重复、是否泄露敏感信息,再将其加入版本化任务库。
每次发布评测结果时,同时发布配置、依赖版本和样本级记录。其他团队复现后,可以报告差异或补充新环境。测试集按版本更新,旧结果不与新结果混在一起。
本地使用者则从公共基准选择相关能力,再加入自己的任务、语言和风险场景。公共测试提供共同坐标,本地测试决定能否上线。
合作过程还应发布异议。某些任务可能存在多个合理答案,某些指标会对语言或表达风格不利。记录这些争议,比强行制造一个统一分数更诚实,也能提示后来者不要超出证据解释结果。
AI 民主化不只是把模型交给更多人,也要把质疑模型的工具交给更多人。开放合作最有价值的成果不是一张永远不变的排行榜,而是一套持续暴露盲区、允许复核和积累共同证据的方法。
## 参考资料