在职场中使用AI编程工具,最重要的问题不是“能不能让它写得更多”,而是“为了完成这个任务,哪些数据必须被读取、哪些绝不能进入请求、输出又该怎样验证”。这是一项数据工程问题,不只是一个设置开关。
Cursor会利用当前文件、打开的标签页、代码库索引和对话上下文来生成建议。上下文越相关,回答通常越好;上下文越宽,暴露面、成本和噪声也越大。合理策略的核心是最小充分上下文。
## 先画清楚数据流
一次AI请求通常包含用户提示、选中的代码、系统补充的仓库片段、模型回复和遥测信息。代码库索引还可能把文件切成片段,计算向量表示,并保存哈希或经过混淆的路径元数据。
因此,“模型有没有训练这些代码”只回答了数据流的一部分。团队还需要知道请求经过哪些后端和模型提供商、明文保留多久、索引保存什么、云端代理是否复制仓库,以及关闭会话后哪些数据仍存在。
Cursor官方资料说明,开启Privacy Mode时,客户数据不用于训练,并对多数模型采用零数据保留安排;同时,请求仍会经过Cursor后端进行提示构建。关闭Privacy Mode时,代码片段、提示和编辑行为可能被用于改进功能。选择设置前,应以当前官方说明为准,而不是依赖同事口头印象。
## 数据分级比“一律允许”更实用
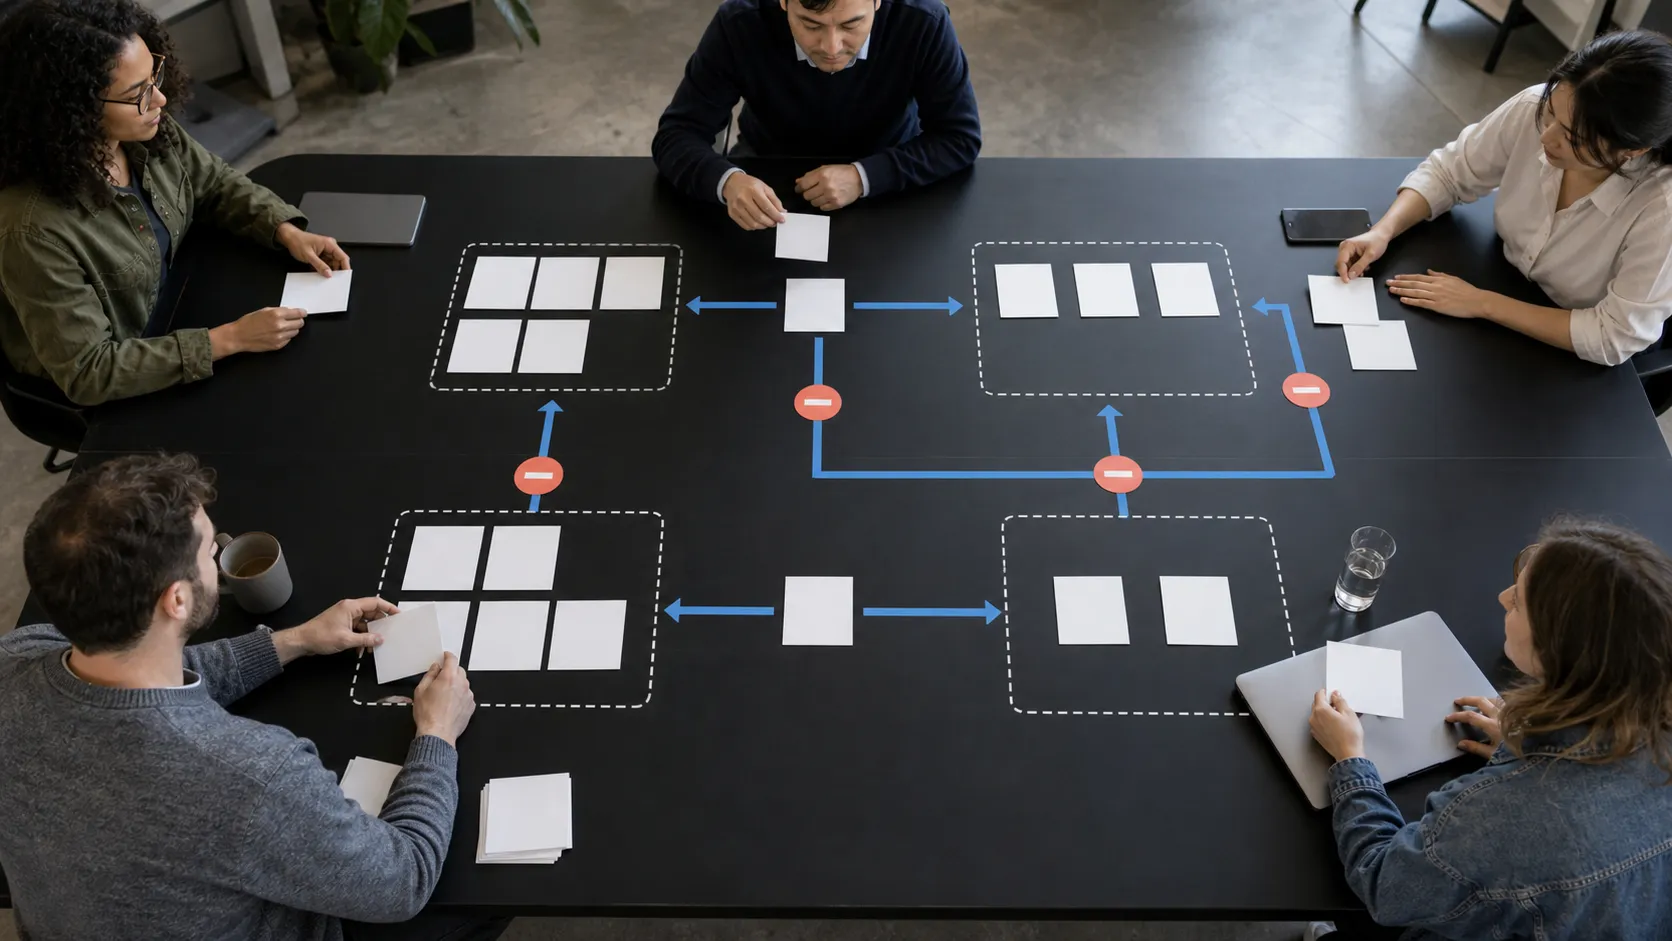
可以把工作资料分为四层。第一层是公开代码、示例和已发布文档,适合用于一般问答。第二层是内部但低敏的业务逻辑,可以在团队批准的环境中使用。第三层包含未发布产品、客户数据和关键算法,只能在明确受控的工具与仓库中处理。第四层是密钥、令牌、私钥和生产凭据,不应进入提示或代码上下文。
分级必须落到文件和任务上。一个公开仓库也可能在本地 `.env` 中保存秘密;一个内部仓库里的测试夹具可能包含真实用户样本。仅按仓库名称判断不够,还要扫描秘密、识别生成数据,并把测试样本替换为合成数据。
`.cursorignore` 可以减少指定文件被索引或加入请求,`.gitignore` 也会影响部分上下文选择。但官方把这种排除描述为“尽力而为”,它不应替代密钥管理。真正的秘密应保存在环境变量、凭据库或独立服务中,并限制本机其他工具访问。
## 上下文策略决定质量和暴露面
面对一个故障,直接加入整个仓库常常不如提供错误日志、相关函数、接口定义和期望行为。窄上下文让模型更容易分辨因果,也减少无关文件被传输。
团队可以把任务拆成三步:先让模型解释现象并列出需要的证据;再只添加相关文件;最后要求生成最小补丁和测试。每次扩展上下文都对应一个明确问题,而不是为了“让模型知道更多”。
共享规则也应写成简洁、可版本化的工程约束,例如测试命令、目录责任、禁止读取的位置和代码风格。规则过长会挤占模型上下文,规则互相冲突则会制造不可预测行为。
## 云端代理需要单独看待
前台聊天通常由本地编辑器选择上下文,而云端代理可能复制仓库、运行终端命令并访问网络。自主性提高后,风险模型也改变:代理可能读取依赖文档、网页或Issue中的恶意指令,并把它们误当成任务要求。
因此,云端任务应使用隔离分支和最小权限令牌,限制网络目的地,禁止访问生产密钥,并在合并前检查差异、依赖和测试输出。敏感仓库如果不允许云端存储,就不应通过“提示它小心”来绕过这一边界。
## 输出也属于数据策略
模型生成的代码可能带有错误假设、过时API或与公开代码相似的片段。团队需要把输出当作未经审查的变更:运行单元测试、静态分析、秘密扫描、依赖检查和人工评审。
还要记录哪些提交使用了AI、使用了哪些上下文类型、由谁复核以及发生了哪些回退。目的不是给每一行代码贴标签,而是让故障发生时能够还原决策链。
衡量成效时,不应只统计接受了多少建议。更重要的是缺陷逃逸率、评审时间、返工次数、上下文大小、每类任务的成功率,以及敏感文件是否被错误纳入。
Cursor在职场中的数据策略,可以归纳为一句话:先确定数据边界,再选择工具能力;先给最小证据,再逐步扩大上下文;最后用原有软件工程控制验证输出。速度来自清楚的边界,而不是把整个工作区一次性交给模型。
## 参考资料