一个人皱眉,可能是不高兴,也可能是阳光刺眼、正在思考或只是面部习惯。AI 可以从表情、语音和文字中估计情感线索,却不能直接读取内心。
因此,“AI情感考核”应该考核模型,而不是给人打情绪分。可靠体系要回答:在什么任务、什么人群、什么环境下,模型能提供多大程度的参考;何时应该明确说“不确定”。
## 先决定到底在预测什么
情感标签有两种常见表示。离散分类把样本分成快乐、愤怒、悲伤、惊讶等类别;连续表示则用效价和唤醒度描述感受偏正还是偏负、强度偏高还是偏低。
两种方法没有绝对优劣。客服对话可能更关心情绪变化与强度,影视检索可能需要多个并存标签,语音交互则可能关注犹豫、急迫和困惑。
任务定义必须说明观察对象和时间尺度。是判断一帧表情、一句话,还是一段对话的变化?如果标签和真实使用单位不同,再高的准确率也没有实际意义。
## 标签本身带有不确定性
情感不是像物体类别那样清楚。一段沉默可能被不同标注者理解为疲惫、尴尬或平静。强迫每个样本只有一个“正确答案”,会把分歧隐藏起来。
更好的数据记录包含多名标注者的选择、强度和一致程度。模型可以学习软标签分布,而不是只学习多数票。考核时也应区分明显样本和高分歧样本。
AffectNet 提供离散表情与效价、唤醒度标注;HEU Emotion 则包含面部、姿态和语音等多模态材料。这些数据集帮助建立基准,也提醒使用者:数据采集方式和标签体系会决定模型学到什么。
## 数据必须按“人”而不是按帧划分
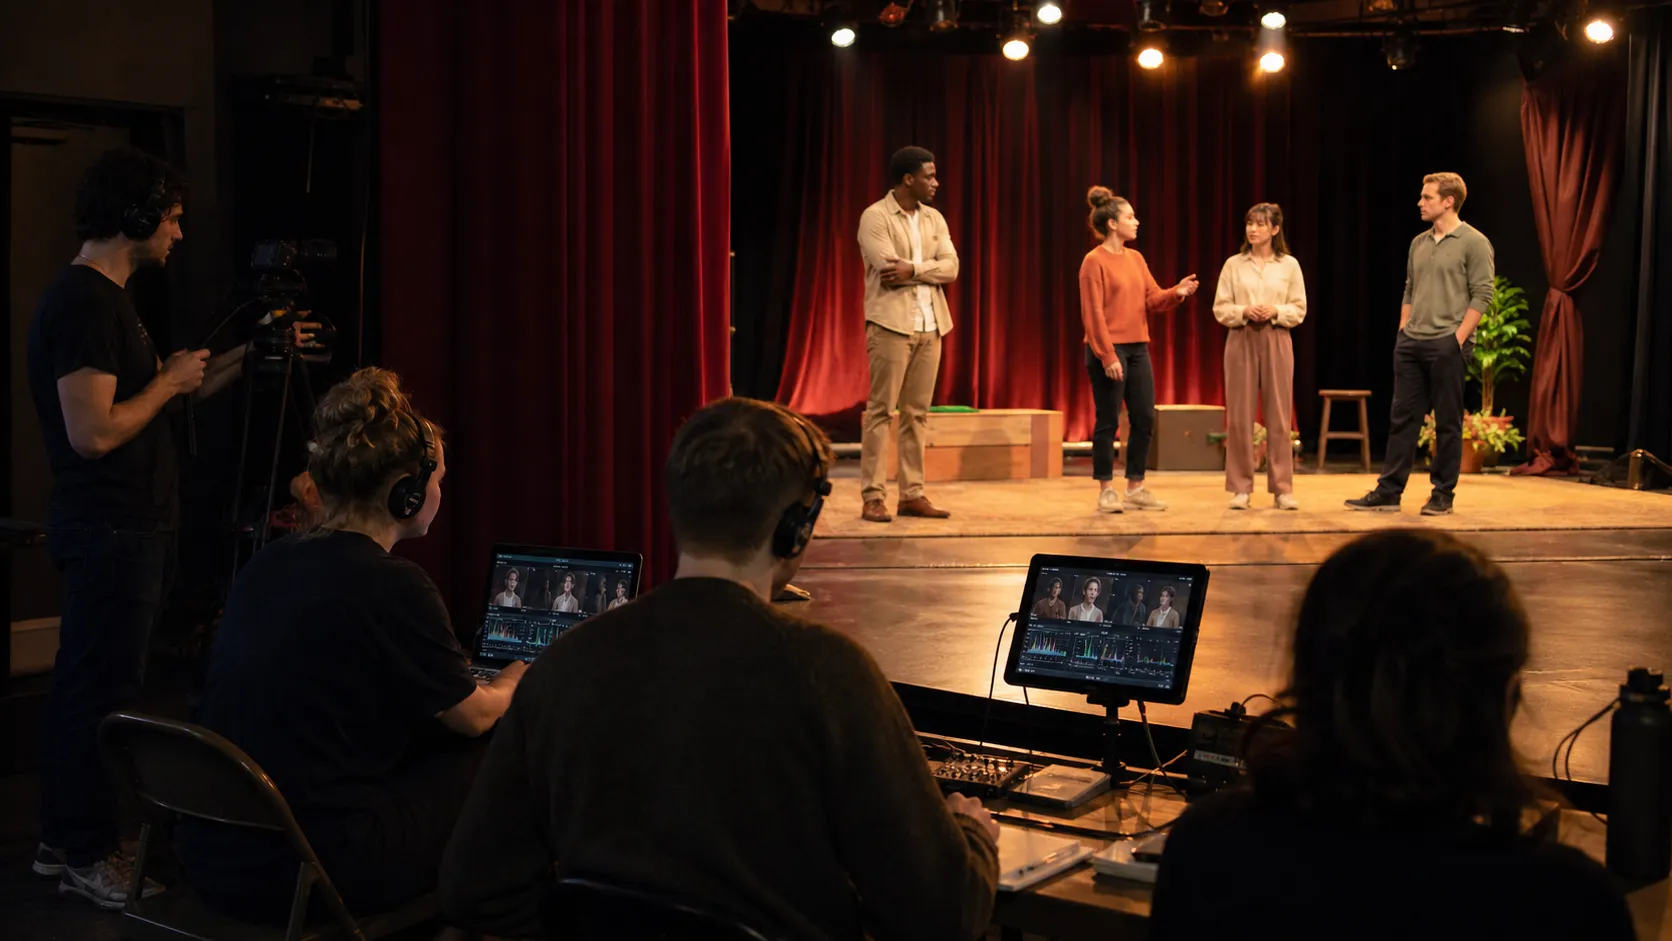
视频中相邻帧非常相似。如果把同一个人的不同帧随机分到训练集和测试集,模型可能记住脸、背景或录制设备,看似准确,却没有学会跨人泛化。
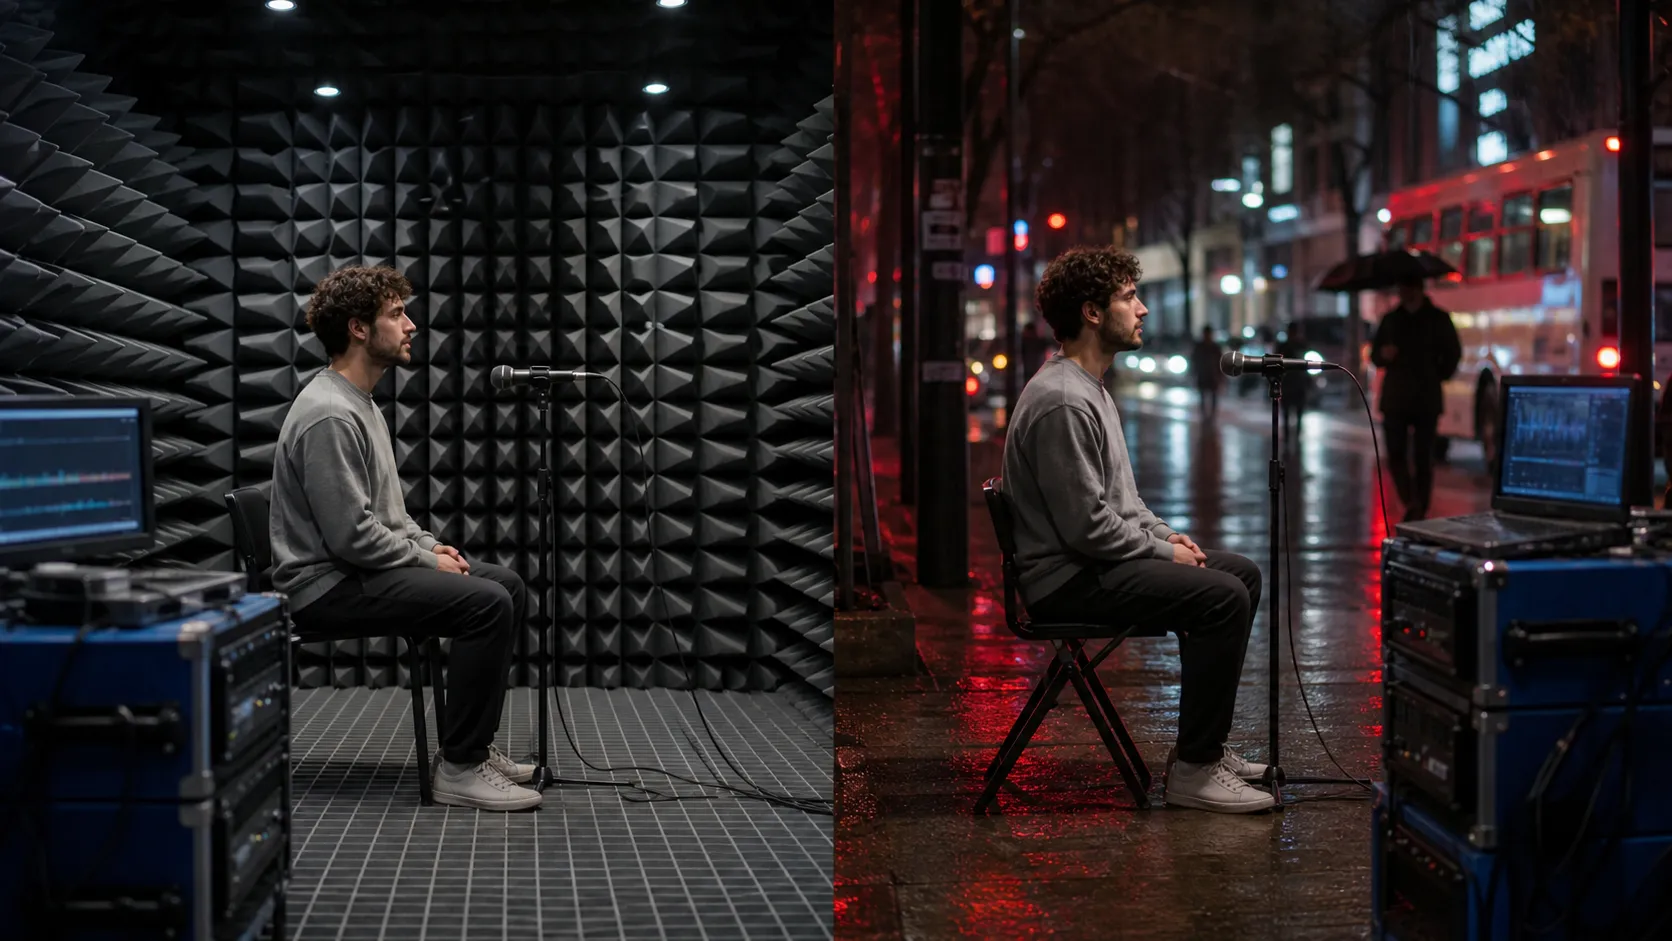
训练、验证和测试应按说话者或参与者隔离。需要跨设备应用时,还要设置跨麦克风、跨摄像头和跨环境测试;需要跨地区使用时,则要检查语言、口音和表达习惯变化。
一个重要指标是跨语料表现:在数据集 A 上训练,到独立采集的数据集 B 上测试。性能下降往往比同分布测试更能揭示模型的真实边界。
## 多模态不是简单平均三个分数
面部、语音和文字提供互补线索。一个人说“真不错”时,文字偏正面,语调和上下文却可能表现为讽刺。
早期融合把不同模态特征放在一起学习;后期融合分别预测再组合;跨模态注意力则学习某段语音和某个词、某个表情之间的对应关系。
考核必须加入模态缺失:摄像头没拍到脸、语音噪声很大、转写错误时会怎样?只在三种信号都完美存在时测试,会高估现实表现。
## 不只看准确率
类别不平衡时,总体准确率可能被常见情感主导。宏平均 F1 会让每个类别拥有相近权重,混淆矩阵能看出“平静”是否总被误判为“悲伤”。连续任务则可以观察相关系数、平均绝对误差和一致性指标。
还要测校准。模型给出 80% 置信度的预测,长期来看是否大约有八成正确?若置信度虚高,系统就难以设置合理的人工复核阈值。
对于连续对话,可考察情感转折的检测延迟、波动稳定性和上下文依赖,而不是逐句孤立评分。
## 给“不知道”保留出口
模型不应被迫对每个样本给出强结论。当画面遮挡、模态冲突、输入超出训练分布或置信度过低时,可以返回“证据不足”。
拒答机制需要单独评估:覆盖率降低多少,留下的预测是否更可靠,拒绝是否集中发生在某类人群或设备上。目标不是让拒答越多越好,而是建立可解释的质量边界。
## 一套可执行的考核流程
先写任务卡,定义标签、输入模态、使用环境和不可支持的结论。再建立按人隔离的基础测试集,覆盖光线、噪声、遮挡、语言和设备差异。
随后设置四组测试:同分布能力、跨场景泛化、模态缺失与扰动、置信度和拒答。每组同时观察总体表现、类别表现和关键子群表现。
最后把真实失败回流到评测集。出现新设备、表达方式或对话场景时,要新增独立样本,而不是不断调参直到旧测试集变好。
## 情感AI适合提供线索,不适合宣判
情感识别可以帮助视频检索、交互节奏调节、可访问性研究和聚合趋势分析。它不应仅凭一次面部或语音预测,推断某个人的品格、诚意或工作态度。
一个成熟的考核体系不会证明模型“看穿了情绪”,而会清楚展示它在哪里有用、在哪里容易误判,以及如何在不确定时退让。越接近人的复杂体验,系统越需要把概率当作概率。
## 参考资料