# AI幻觉危机:大模型可靠性陷阱与可信AI构建路径
> **研判日期**:2026年8月
> **核心命题**:当AI"一本正经地胡说八道",产业信任如何重建?
> **导读**:AI从不承认"我不知道"——不知道的时候,它就编。这篇讲清楚幻觉为什么必然存在、在哪些场景会出人命,以及怎么把幻觉"关进笼子"。
---
## 一、核心摘要
AI幻觉——大模型生成看似合理但完全虚假的信息——是2026年制约AI从"辅助工具"升级为"核心生产力"的最大障碍。
同样是幻觉,代价天差地别:**写文案时胡说一句,顶多重写;但在金融对账、法务审核、医疗辅助、工业运维这些专业场景,一次幻觉就可能造成决策失误、合规违规、财产损失甚至安全事故。**这不是危言耸听——真实世界里,律师因为引用AI编造的判例被法院罚款,科技公司因为发布会Demo说错一句话市值蒸发上千亿美元。
本报告拆解幻觉的生成机制(它不是bug,是大模型的"工作原理")、三大类型、高危场景,并给出2026年的解法:三层防幻觉体系 + 风险分级管理。
> **案例·真实世界的两次"幻觉事故"**:
> **① 律师被罚(2023年,美国)**:律师用 ChatGPT 准备诉讼材料,引用了6个"支持己方"的判例——全是AI编的,一个都不存在。法官核实后怒了,律师被处以罚款,成为全球AI幻觉的标志性案例。
> **② 发布会翻车(2023年2月,谷歌)**:谷歌发布 Bard 的宣传Demo里,Bard 说"詹姆斯·韦伯太空望远镜拍摄了第一张系外行星照片"——这是错的(第一张早在2004年就拍到了)。短短几天,Alphabet 市值蒸发约千亿美元。**AI胡说一句话,误差以百亿美元计。**
---
## 二、幻觉的本质:概率生成 vs 事实逻辑
先破除一个幻想:幻觉不是"修一修就能没"的bug。**它是大模型工作原理的固有副产品。**
### 2.1 幻觉的生成机制
```
用户输入 → 模型解析 → 概率预测 → Token生成
↑
训练数据中的统计模式
(而非事实数据库)
```
关键在这:**大模型的本质是"预测下一个词的概率",它肚子里装的是统计规律,不是事实数据库。**人说话之前会想"这是不是真的",模型生成之前只想"哪个词接 here 最顺"。
**核心矛盾**:
### 2.2 幻觉的三种类型
| 类型 | 描述 | 典型场景 | 危害等级 |
|------|------|------|:---:|
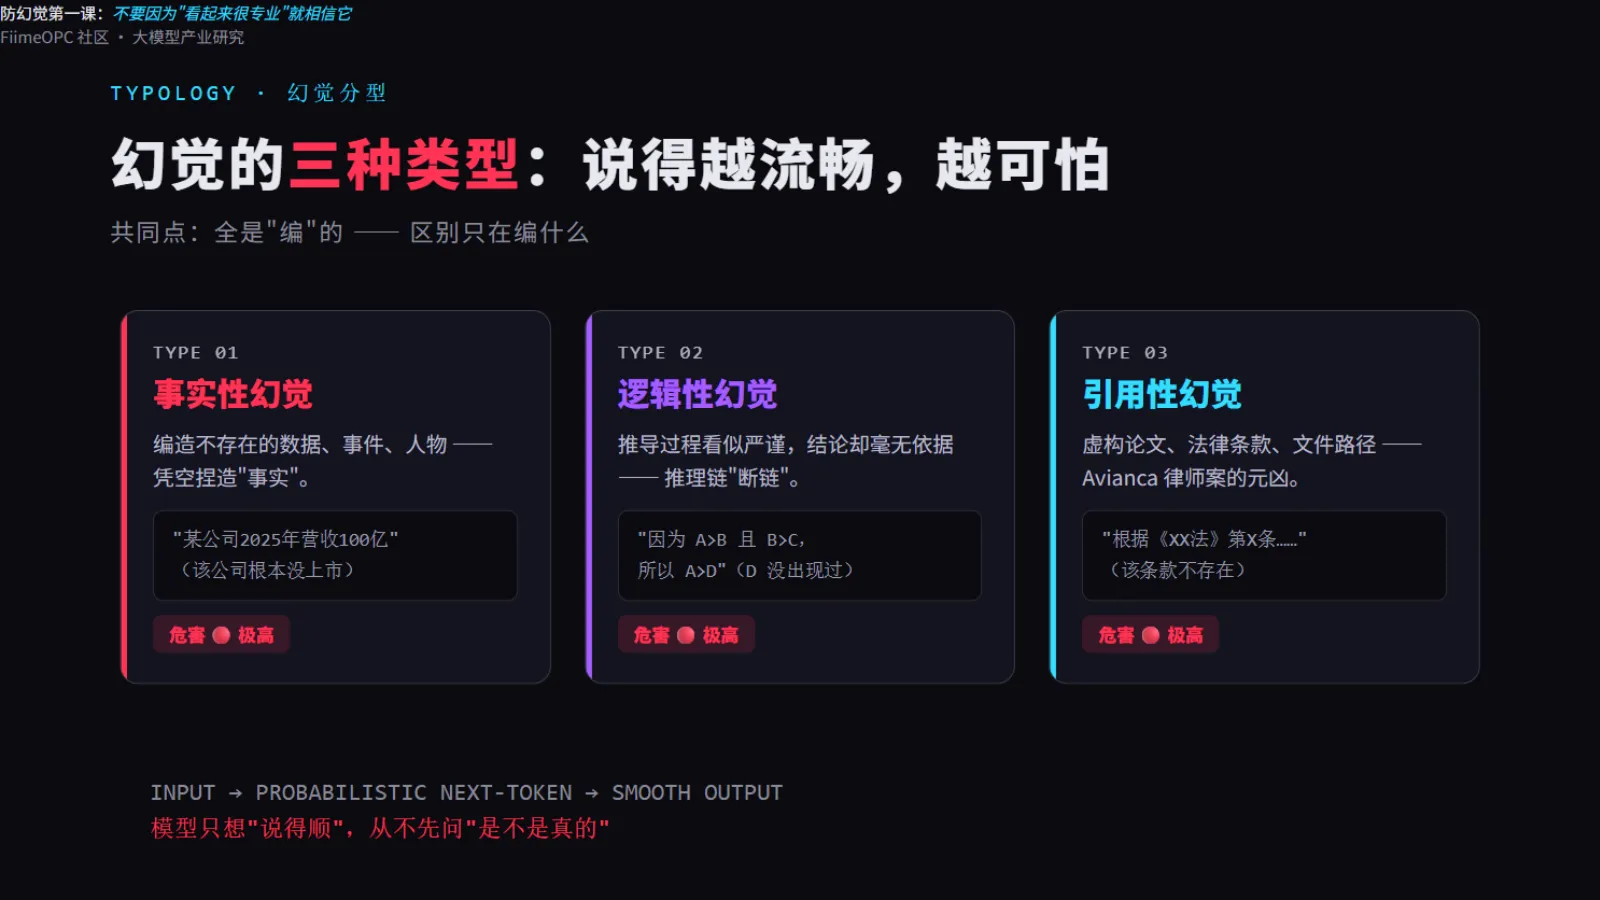
| 事实性幻觉 | 编造不存在的数据、事件、人物 | "某公司股票2025年营收100亿"(实际未上市) | 🔴 极高 |
| 逻辑性幻觉 | 推导过程看似合理,但结论错误 | "因为A>B且B>C,所以A>D"(D未在前提中出现) | 🔴 极高 |
| 引用性幻觉 | 虚构论文、法律条款、文件路径 | "根据《XX法》第X条..."(该条款不存在) | 🔴 极高 |
三种幻觉的共同点:**说得越流畅,越可怕。**那位被罚款的律师,就是被"引用性幻觉"坑的——判例名称、判决年份、核心论点,编得有模有样。
### 2.3 为什么越强的模型幻觉越严重?
| 因素 | 解释 |
|------|------|
| 生成能力过强 | 模型太擅长"自圆其说",让虚假信息更具欺骗性 |
| 训练数据滞后 | 模型知识有截止日期,面对新事件只能"编造" |
| 指令遵循过度 | 模型被训练成"必须回答",即使不知道也要猜 |
| 多步推理放大 | 长流程任务中,每一步的小错误被后续步骤放大 |
反直觉但真实:**模型越强,幻觉的"演技"越好。**老模型胡说八道一眼假,新模型编得跟真的一样——这也是为什么幻觉焦虑不降反升。
---
## 三、幻觉的高危场景地图
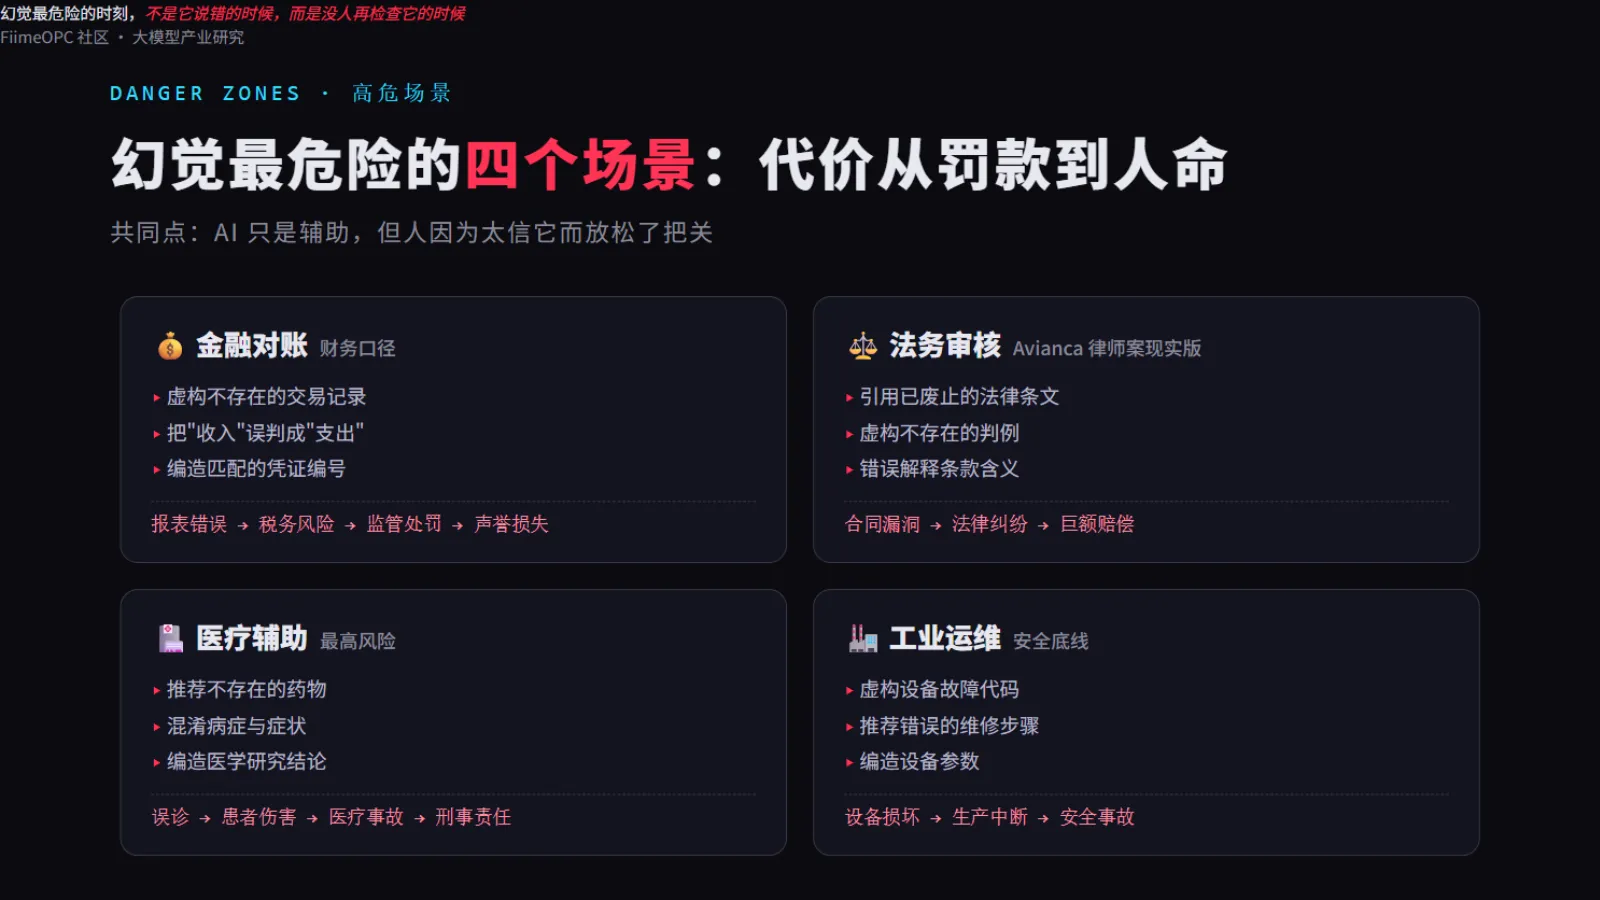
四个场景,幻觉的代价从"罚款"到"出人命"。
### 3.1 金融对账
```
场景:AI辅助核对银行流水与企业账目
幻觉表现:
后果:财务报表错误 → 税务风险 → 监管处罚 → 声誉损失
```
### 3.2 法务审核
```
场景:AI辅助审查合同条款
幻觉表现:
后果:合同漏洞 → 法律纠纷 → 巨额赔偿
```
Avianca 律师案就是这一格的现实版。
### 3.3 医疗辅助
```
场景:AI辅助诊断建议
幻觉表现:
后果:误诊 → 患者伤害 → 医疗事故 → 刑事责任
```
### 3.4 工业运维
```
场景:AI辅助设备故障诊断
幻觉表现:
后果:设备损坏 → 生产中断 → 安全事故
```
四个场景的共同点:**AI 只是"辅助",但人会因为太信它而放松把关。**幻觉最危险的时刻,不是AI说错的时候,而是没人再检查它的时候。
---
## 四、传统防幻觉手段的局限
| 手段 | 做法 | 局限 |
|------|------|------|
| 扩大训练数据 | 增加更多数据训练 | 无法覆盖实时更新的信息 |
| 优化Prompt | 写更详细的提示词 | 无法适配复杂多变的业务场景 |
| 人工复核 | 每份AI输出人工检查 | 大幅降低效率、增加成本,失去AI意义 |
| 温度调低 | 降低生成随机性 | 减少创造性但无法根除幻觉 |
**共同问题**:都是"治标"而非"治本",幻觉率仅能从"高"降到"中",无法达到生产级要求的"极低"。
---
## 五、2026年突破:全链路AI对齐技术
### 5.1 三层防幻觉体系
```
┌─────────────────────────────────────────┐
│ 表层:结果复盘层 │
│ ├── 逻辑复盘:梳理推理链路 │
│ ├── 一致性校验:排查数据矛盾 │
│ └── 自主修正:修正偏差内容 │
├─────────────────────────────────────────┤
│ 中层:运行校验层 │
│ ├── 实时联网溯源:联动权威数据库 │
│ ├── 知识库比对:与结构化知识比对 │
│ └── 规则校验:验证业务规则合规性 │
├─────────────────────────────────────────┤
│ 底层:模型对齐层 │
│ ├── 事实性对齐训练:矫正概率生成偏差 │
│ ├── 未知不臆造:训练模型承认无知 │
│ └── 缺数据不编造:强化数据边界意识 │
└─────────────────────────────────────────┘
```
用人话说这套体系:**底层让模型"少编",中层让输出"有据可查",表层让结果"自检"。**其中最实用的当属 RAG(检索增强生成)——先从你的企业知识库里查到依据,再让模型照着依据回答,等于给AI配了个"开卷考试"。
### 5.2 关键技术突破
| 技术 | 原理 | 效果 |
|------|------|------|
| 事实性对齐训练 | 在预训练阶段注入"事实优先"目标 | 降低原生幻觉概率 |
| RAG增强生成 | 检索外部知识库后再生成 | grounding 生成内容于真实数据 |
| 链式验证 | 多模型交叉验证同一结论 | 发现单一模型的幻觉 |
| 不确定性量化 | 让模型输出"置信度分数" | 对低置信度结果触发人工复核 |
| 人机协同审批 | 高风险操作必须人工确认 | 最后一道防线 |
---
## 六、企业级防幻觉实施框架
### 6.1 风险分级
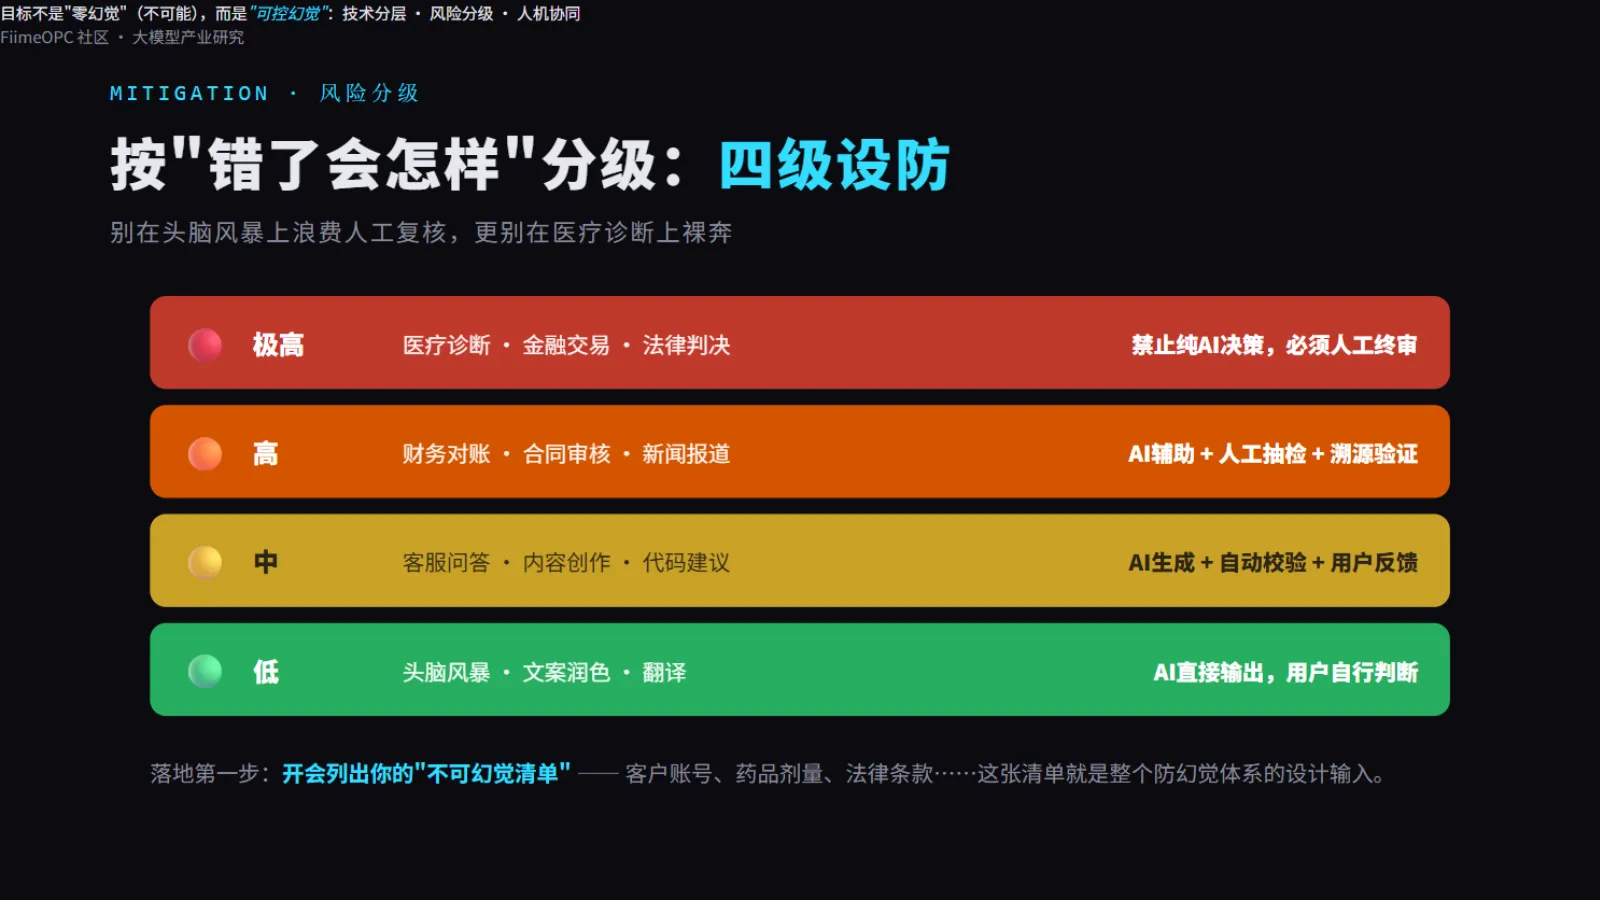
不是所有场景都要同等设防——按"错了会怎样"分级管理:
| 风险等级 | 场景示例 | 防幻觉策略 |
|:---:|------|------|
| 🔴 极高 | 医疗诊断、金融交易、法律判决 | 禁止纯AI决策,必须人工终审 |
| 🟠 高 | 财务对账、合同审核、新闻报道 | AI辅助+人工抽检+溯源验证 |
| 🟡 中 | 客服问答、内容创作、代码建议 | AI生成+自动校验+用户反馈 |
| 🟢 低 | 头脑风暴、文案润色、翻译 | AI直接输出,用户自行判断 |
这张表的用法:**先给你的AI应用场景定级,再按级设防**——别在头脑风暴上浪费人工复核,更别在医疗诊断上裸奔。
### 6.2 实施 checklist
```
□ 建立业务场景的"不可幻觉清单"(哪些信息绝对不能错)
□ 部署实时联网溯源系统,确保关键数据可验证
□ 构建领域知识库,作为RAG的 grounding 来源
□ 设置不确定性阈值,低置信度自动转人工
□ 建立幻觉事件记录与分析机制,持续优化
□ 为高风险场景配置"人机协同审批"流程
□ 购买AI错误责任保险,转移残余风险
```
第一条最重要:**开会先把"绝对不能错的信息"列出来**——客户的账号数字、药品剂量、法律条款……这张清单就是你整个防幻觉体系的设计输入。
---
## 七、趋势展望
---
> **核心结论**:幻觉不是大模型的"bug",而是其"概率生成"本质的固有特征。企业不应追求"零幻觉"(不可能),而应建立"可控幻觉"体系——通过技术分层、风险分级、人机协同,将幻觉的危害控制在可接受范围内。