“AI 绘画”和物流看起来相距很远:一个生成像素,一个搬运真实货物。但仓库视觉模型要认识托盘、包裹、叉车和破损,训练这些模型需要大量图片;新仓库在施工前也需要可视化布局和模拟流程。
生成式图像在这里确实有用,却不能替代摄像头、条码、称重和真实验货。它更像物流视觉系统的训练场与草图纸,而不是事实记录仪。
## 合成图像首先解决“拍不到”
真实仓库的大多数包裹完好、光照稳定、流程正常。严重破损、遮挡、危险堆叠和传送带卡滞很少发生,却恰好是模型最需要识别的情况。
如果只从日常录像取样,数据会高度失衡。团队也不能为了拍摄而故意制造危险事故。三维仿真和生成模型可以批量产生罕见场景,并自动得到物体类别、边界框、深度和分割掩码。
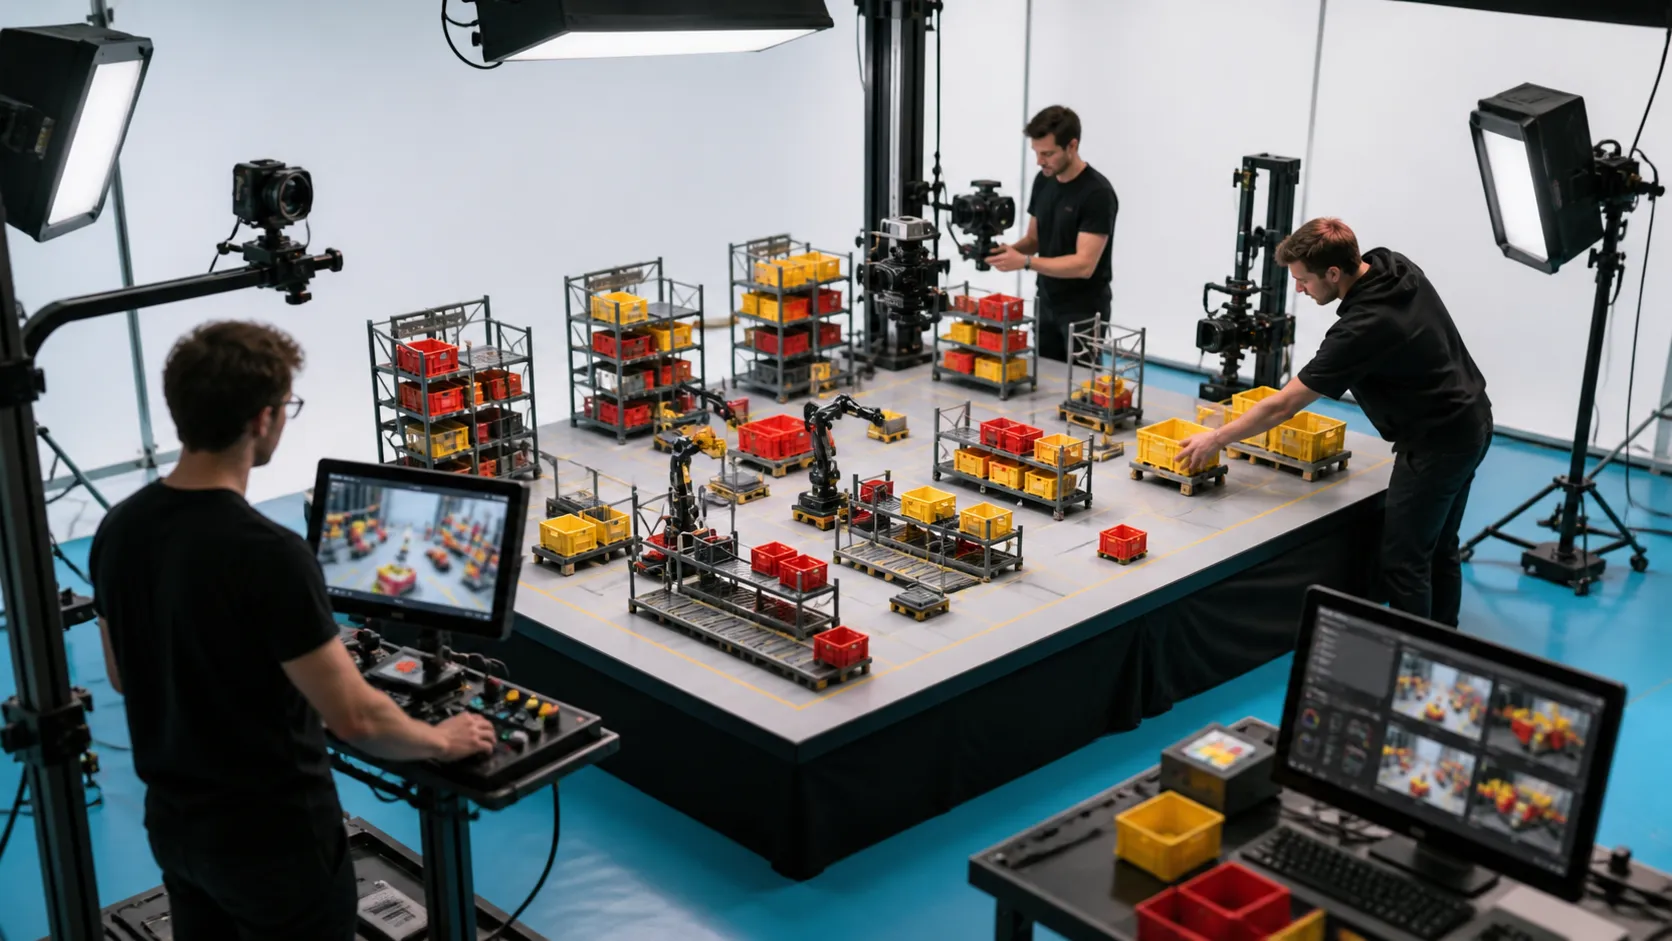
NVIDIA Isaac Sim 的合成数据教程展示了仓库场景中的域随机化:系统改变光照、物体位置、颜色、相机角度和干扰物,再生成成千上万帧训练数据。随机化的目标不是每张图都像照片,而是迫使视觉模型抓住跨环境稳定的特征。
## “画得像”不等于“训练有效”
一张合成仓库图可以非常逼真,却缺少真实镜头的压缩噪声、运动模糊、灰尘反光和传感器畸变。模型若学会了渲染器特有的纹理,到真实仓库就可能失效,这被称为现实差距。
域随机化用大量外观变化减少对某一种渲染风格的依赖。另一条路线是把真实背景和合成物体组合,或用少量真实数据做最后微调。
与英国在线超市合作的研究曾展示从真实商品建立三维资产、生成仓库合成图,再训练物体识别模型的完整流程。它说明合成数据能降低标注成本,但并没有取消真实对象采集和真实场景验证。
真正应该比较的不是人眼更喜欢哪张图,而是加入合成数据后,模型在从未见过的真实测试集上是否更准。
## 生成式图像可以扩展哪些物流任务
第一类是物体检测与抓取。系统可以改变包裹姿态、堆叠密度和遮挡,训练机械臂识别可抓取区域。第二类是缺陷识别,例如压痕、撕裂、湿损或标签错位;稀有缺陷可先在仿真中形成候选样本。
第三类是仓库数字孪生。设计团队在设备落地前模拟货架、通道、摄像头和照明位置,检查视野盲区与交通冲突。生成图像帮助人快速比较方案,物理仿真则负责碰撞、速度和容量等可计算约束。
第四类是培训与沟通。把事故记录重建成不包含真实客户信息的场景,能让员工练习识别风险;把抽象流程转成连贯画面,也能帮助不同工种讨论同一个布局。
这些任务的共同点是“探索可能发生什么”,而不是证明“刚才真实发生了什么”。
## 不能替代真实影像的三种原因
首先,生成图像没有现场证据属性。它可以描绘一个破损包裹,却不能证明某件货物在某时某地确实破损。追踪和验收仍依赖真实传感器记录。
其次,生成模型会补全看似合理但不存在的细节。包装结构、条码位置、机械间隙和货架连接件都可能被画错。画面越逼真,人越容易忽略这些几何错误。
最后,物流环境不断变化。新包装材料、不同相机、季节光照和设备磨损会改变数据分布。只在旧仿真里表现良好的模型,无法自动适应新仓库。
因此,“替代真实数据”是错误目标。更合理的目标是用合成数据覆盖长尾,再用真实数据校准和验收。
## 一条可靠的共生链
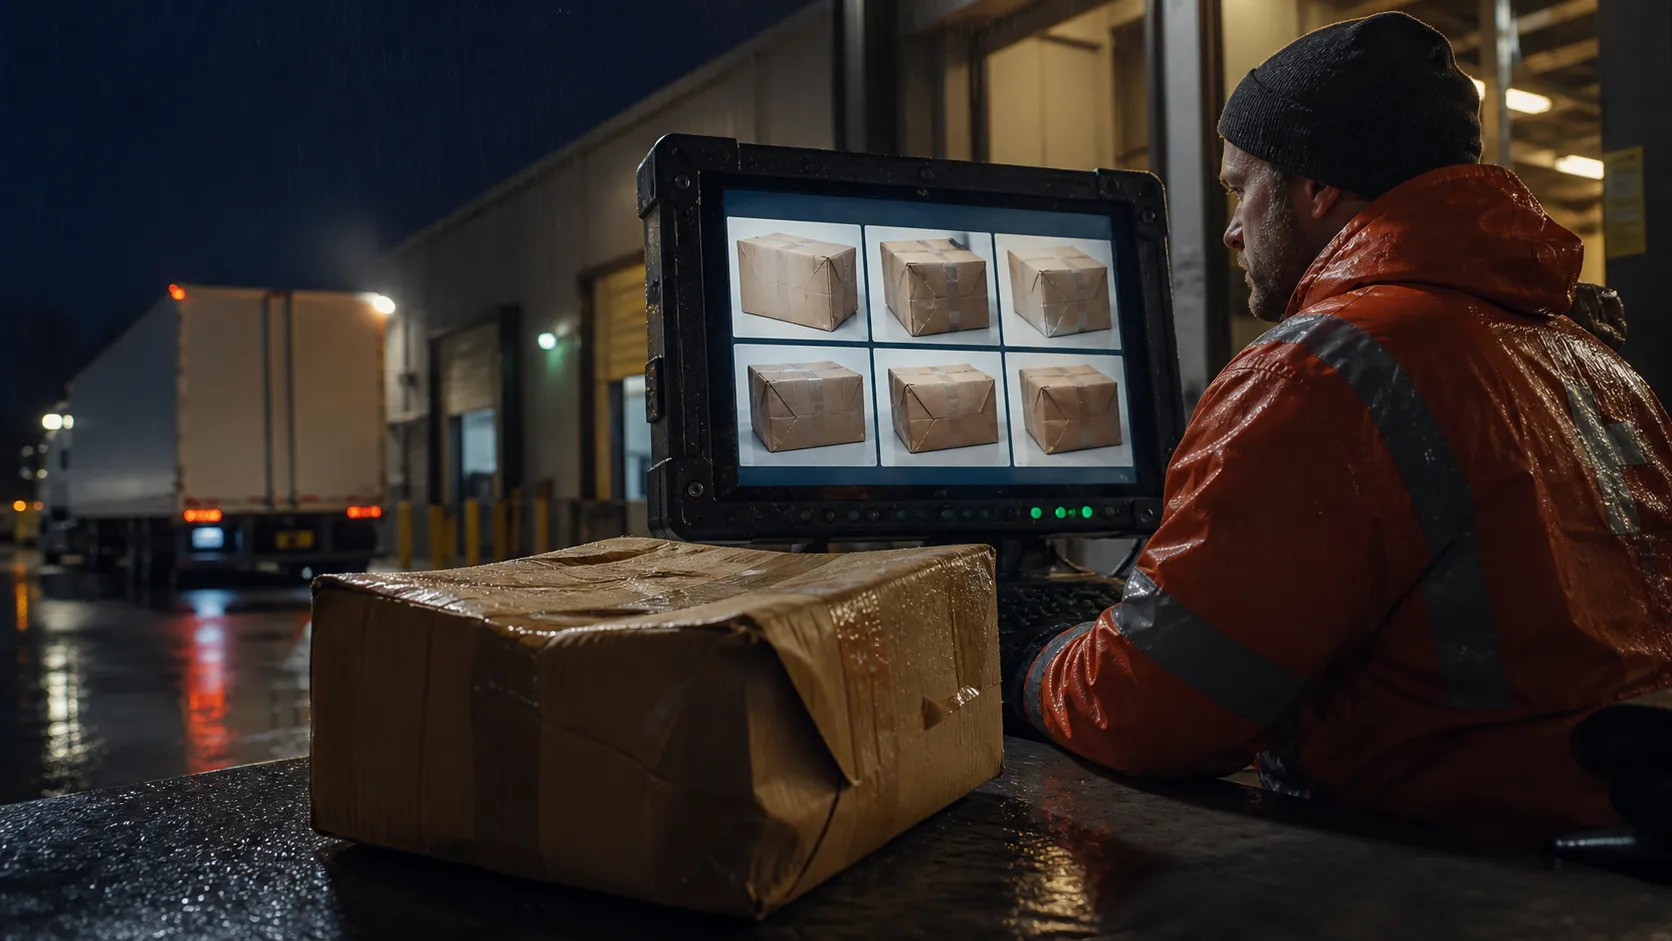
第一步从真实场景建立基线:拍摄不同班次、相机和仓库区域,并保留从未参与训练的真实测试集。第二步分析模型在哪些切片上失败,例如透明膜反光、黑色包裹、极端遮挡或夜间装卸。
第三步只针对这些缺口生成合成样本,并保留生成参数。第四步混合训练,比较纯真实、纯合成和混合数据三种方案。第五步在真实测试集和小规模现场运行中重新验收。
这个闭环比盲目扩充百万张“漂亮仓库图”更有效,因为每一批合成数据都对应一个可测量的现实失败。
## 评测要盯住真实任务
物体检测可按仓库、相机、光照、遮挡和包装材质分组计算精确率与召回率。缺陷任务还要关注长尾:误报太多会让质检员疲劳,漏报严重损坏则直接失去价值。
机器人任务不能只看图片识别率,还要测抓取成功率、碰撞率和每小时处理量。数字孪生方案也应由真实尺寸和流程数据约束,而不是依据画面美观做决定。
近期针对仓储物流的合成数据研究同样强调与真实数据的对比。最可靠的结论往往不是“合成数据胜过真实数据”,而是它在某些稀缺切片上补足了覆盖。
## 创业机会在连接层
生成一张仓库图的门槛正在降低,真正困难的是把仓库 CAD、商品三维资产、相机参数、标注格式、训练框架和现场评测连成一条可重复流水线。
因此,可持续产品更可能出现在数据缺口诊断、可控场景生成、自动标注、仿真资产管理和真实回归测试,而不是一个通用“物流绘画”按钮。
AI 绘画与物流的关系最终不是共生还是替代的二选一。生成图像负责扩大训练世界,真实传感器负责锚定物理世界;只有两者反复校准,视觉模型才有机会在真正的仓库里可靠工作。
## 参考资料