# 模型选型迷宫:百花齐放时代的企业大模型选择困境
> **研判日期**:2026年8月
> **核心命题**:当没有"全能冠军",企业如何在模型丛林中找到最优解?
> **导读**:GPT、Claude、Gemini、通义千问、文心一言、DeepSeek……每个都说是最强的。这篇告诉你:为什么"选最强"是错的问题,以及正确的选型姿势。
---
## 一、核心摘要
2025-2026年,大模型市场进入"百花齐放"阶段,但企业在选型时掉进了一个反直觉的坑:**没有单一模型能在所有场景下表现最优**——代码写得最好的,中文长文本未必行;中文最好的,成本可能是别人的几十倍。而为了"都试试",企业又背上了成本、复杂度、合规的三重压力。
一句话总结困境:**企业需要的不是"最强模型",而是"最适合自己场景的模型",但"适合度"恰恰最缺评估标准。**本报告拆解选型的三重迷雾,给出"场景驱动、数据说话、渐进验证"的选型方法论,最后介绍大厂的"模型组合"打法——不押注单一模型,按任务动态分配。
> **案例·行业已经在这么干**:LMSYS 的 Chatbot Arena 用真实用户盲测投票排出模型天梯榜,信通院建立了国内的大模型标准评测体系——第三方评估正在成熟。但注意:**榜单衡量的是"通用能力",你的业务场景是"私人考卷"**。榜单前几名之间可能差 1 分,但到了你的具体任务上,差距可能被放大成"能用"和"不能用"。
---
## 二、选型困境的"三重迷雾"
选型难,难在三团雾:看不清性能、算不清成本、看不见合规红线。
### 2.1 迷雾一:性能差异的场景化
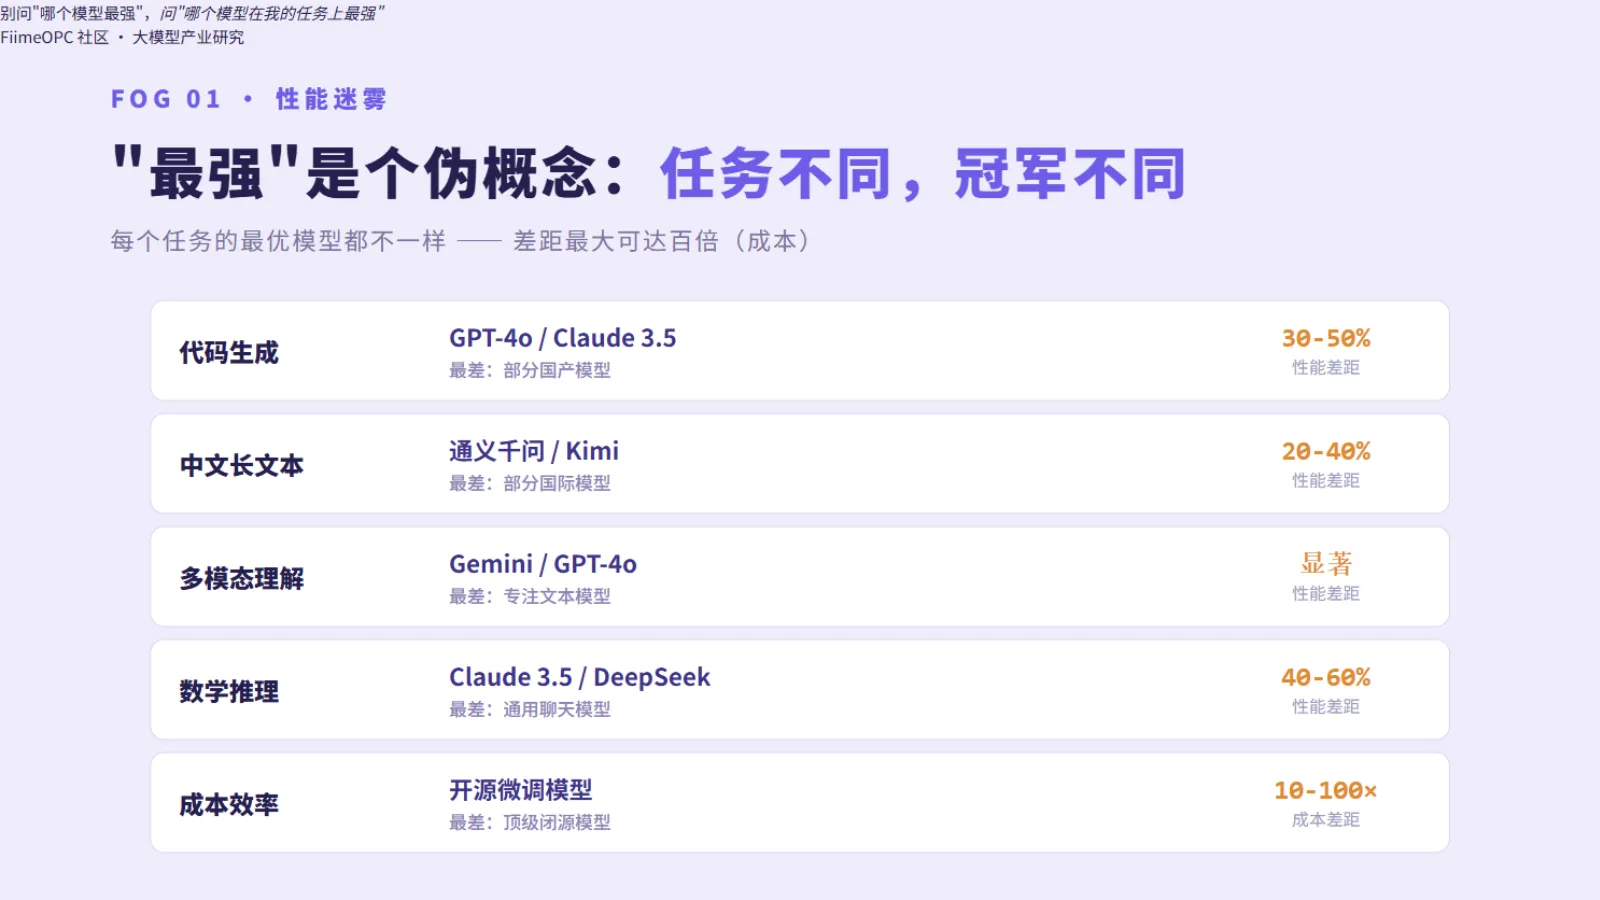
| 任务类型 | 表现最优模型 | 表现最差模型 | 差距 |
|------|------|------|------|
| 代码生成 | GPT-4o / Claude 3.5 | 部分国产模型 | 30-50% |
| 中文长文本 | 通义千问 / Kimi | 部分国际模型 | 20-40% |
| 多模态理解 | Gemini / GPT-4o | 专注文本模型 | 显著 |
| 数学推理 | Claude 3.5 / DeepSeek | 通用聊天模型 | 40-60% |
| 成本效率 | 开源微调模型 | 顶级闭源模型 | 10-100倍 |
这张表是全文的钥匙:**"最强"是个伪概念,"最强"永远带一个后缀——"在什么任务上"。**就像招人,"最聪明的人"未必是最适合这个岗位的人。
**核心矛盾**:企业需要的不是"最强模型",而是"最适合自己场景的模型",但评估"适合度"缺乏标准工具。
### 2.2 迷雾二:成本核算的复杂性
| 成本项 | 影响因素 | 可控性 |
|------|------|:---:|
| API调用费 | Token消耗量、模型等级、并发量 | 中 |
| 上下文长度溢价 | 长文本场景需高上下文模型,单价更高 | 低 |
| 微调成本 | 数据准备、训练算力、迭代调优 | 低 |
| 合规附加成本 | 数据本地化、审计、安全加固 | 低 |
| 切换成本 | Prompt重写、工作流调整、团队再培训 | 极低 |
注意最后一行:**切换成本看似"极低",其实是最大的隐藏账单**——Prompt 全部重写、工作流重新调试、团队重新培训,这些都不写在模型报价单上。
**核心矛盾**:选型时的成本预估与实际运行成本往往相差数倍,企业陷入"预算失控"焦虑。
### 2.3 迷雾三:合规性的隐形边界
| 合规维度 | 限制 | 影响 |
|------|------|------|
| 数据出境 | 使用境外API可能导致数据跨境传输违规 | 限制国际模型使用 |
| 内容审核 | 不同模型对敏感内容的处理策略不同 | 影响品牌安全 |
| 行业准入 | 金融、医疗等行业对AI供应商有资质要求 | 限制模型选择范围 |
| 开源协议 | 部分开源模型有商业使用限制 | 潜在法律风险 |
这一团雾最容易被忽略,却最致命:**性能再好的模型,合规不过关就是零分**。金融、医疗、政务行业的选型清单上,"能不能数据本地化"排在"能力强不强"前面。
---
## 三、选型困境的量化影响
### 3.1 时间成本
```
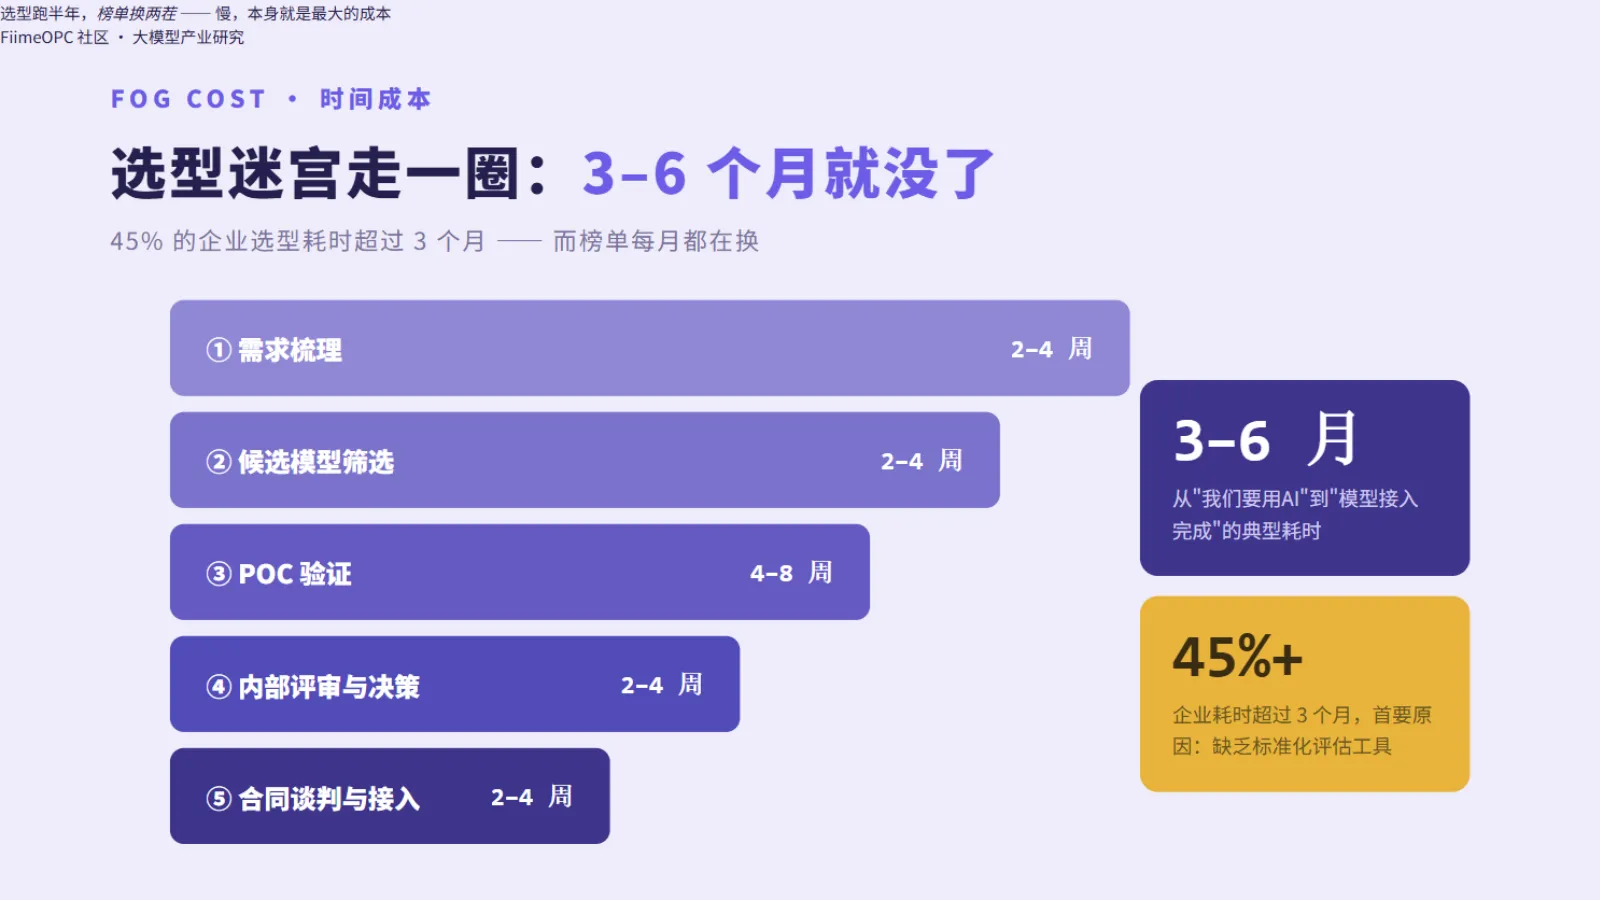
典型企业大模型选型周期:
需求梳理(2-4周)
↓
候选模型筛选(2-4周)
↓
POC验证(4-8周)
↓
内部评审与决策(2-4周)
↓
合同谈判与接入(2-4周)
↓
总计:3-6个月(超过45%的企业耗时3个月以上)
```
一个业务需求,光"选模型"就走半年。而市场的模型一个月更新好几轮——**等你选完,榜单都换了两茬了。**
### 3.2 机会成本
### 3.3 决策质量
| 选型方式 | 占比 | 结果 |
|------|:---:|------|
| 跟风选择(用最多人用) | 35% | 可能不适合自身场景 |
| 关系选择(销售推哪个) | 25% | 易受商业利益误导 |
| 成本选择(选最便宜的) | 20% | 性能可能不达标 |
| 数据驱动(基于评估基线) | 15% | 最优但门槛高 |
| 其他 | 5% | — |
这张表应该反过来读:**只有 15% 的企业在用"数据驱动"选型——也就是唯一靠谱的那种。**85% 的企业在跟风、看关系、贪便宜。
---
## 四、深层原因:为什么选型这么难?
### 4.1 信息不对称
厂商榜单就像"厂商自己出的广告",考题、评分标准都对自己有利。
### 4.2 评估能力缺失
这又绕回了上一篇《人才荒漠》的结论:**缺的是能把"业务问题"翻译成"评估题目"的人。**
### 4.3 FOMO驱动
---
## 五、破局方法论:"场景驱动、数据说话、渐进验证"
四步走:拆场景、建基线、慢慢验、做组合。
### 5.1 第一步:场景拆解
```
将业务需求拆解为模型任务类型:
业务场景:智能客服
├── 任务1:意图识别(分类任务)
├── 任务2:知识问答(RAG检索+生成)
├── 任务3:情感分析(分类任务)
└── 任务4:多轮对话(长上下文推理)
→ 不同任务可能适合不同模型
→ 而非"一个模型解决所有"
```
**别问"哪个模型最好",把业务拆成具体任务,再逐个问"哪个模型最擅长这件事"。**
### 5.2 第二步:构建评估基线
| 评估维度 | 指标 | 权重 |
|------|------|:---:|
| 任务准确率 | 在业务测试集上的正确率 | 30% |
| 响应速度 | 首Token延迟、总生成时间 | 20% |
| 成本效率 | 每千次调用的综合成本 | 20% |
| 稳定性 | 并发场景下的可用性 | 15% |
| 合规性 | 数据本地化、内容安全 | 15% |
关键动作:**用你自己的业务数据出一套"私人考卷"(测试集),让候选模型现场考试。**考卷上的题,就是你们真实的客户咨询、真实的合同条款、真实的工单。
### 5.3 第三步:渐进验证
```
Phase 1:单任务验证(2周)
└── 用最小数据集验证核心任务表现
Phase 2:端到端验证(4周)
└── 在真实业务数据上跑通完整流程
Phase 3:小流量上线(4周)
└── 5-10%真实流量接入,观察实际表现
Phase 4:全量推广(持续)
└── 根据数据反馈持续优化
```
**每一步都有明确的 Go/No-Go 标准,不达标就停**——把选型从"赌博"变成"实验"。
### 5.4 第四步:多模型策略
```
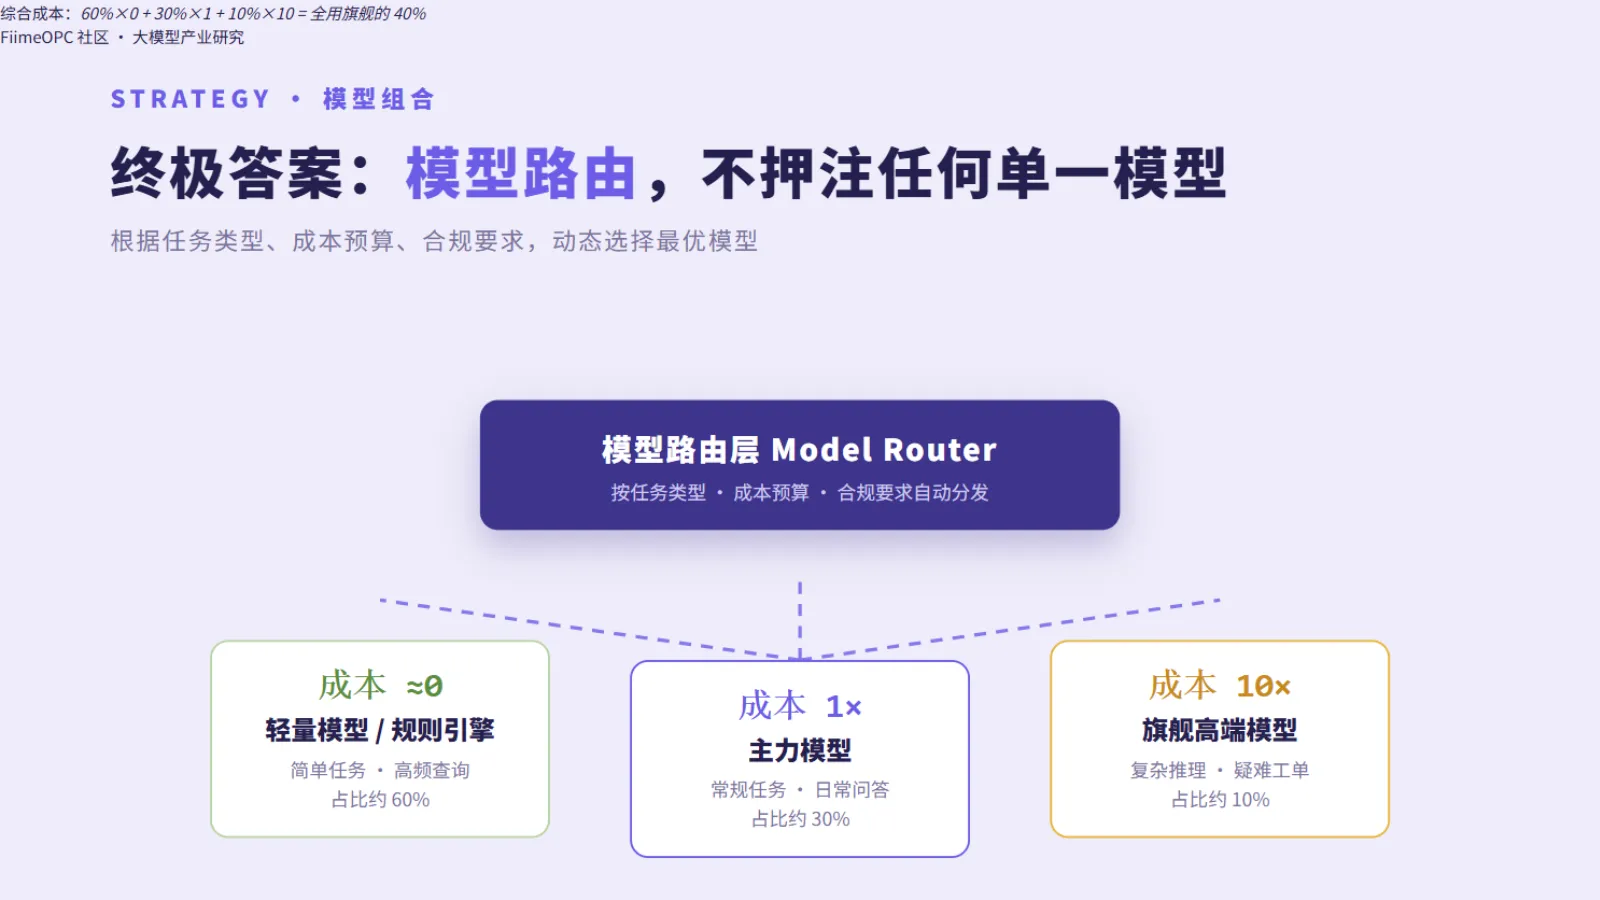
┌─────────────────────────────────────┐
│ 模型路由层(Model Router) │
│ 根据任务类型、成本预算、合规要求动态选择 │
└─────────────────────────────────────┘
│
┌──────┼──────┐
▼ ▼ ▼
轻量模型 主力模型 高端模型
(简单任务) (常规任务) (复杂任务)
```
**核心原则**:不追求"一个模型打天下",而是构建"模型组合",在不同场景调用最优模型。
> **案例·组合拳是主流打法**:一线互联网公司的AI系统普遍采用"模型路由"架构——简单意图识别走轻量小模型(成本近零),常规问答走性价比模型,复杂推理才调用旗舰模型。这样既控住了成本,又不会被单一厂商"绑架"。这个思路对中小企业同样适用:哪怕是"主力用一个、兜底用一个"的双模型配置,也比单点依赖稳健得多。
---
## 六、工具与资源
| 类型 | 工具/资源 | 用途 |
|------|------|------|
| 评估框架 | ai-eval、lm-evaluation-harness | 系统化模型对比 |
| 成本监控 | Token用量仪表盘、成本告警 | 实时追踪算力支出 |
| 模型市场 | Hugging Face、ModelScope | 获取开源模型和微调版本 |
| 社区评测 | LMSYS Chatbot Arena | 参考人类偏好的模型排名 |
| 行业基准 | 信通院大模型评测体系 | 合规性与安全性评估 |
---
## 七、趋势展望
---
> **核心结论**:模型选型困境的本质不是"选择太多",而是"标准太少"。企业需要建立基于自身业务数据的评估体系,用数据驱动替代感觉驱动,用渐进验证替代一步到位,用模型组合替代单一依赖。